
Retriever AI (rtrvr.ai)Freemium
Webaufgaben beschreiben, strukturierte Ergebnisse prüfen und Abläufe wiederholen.
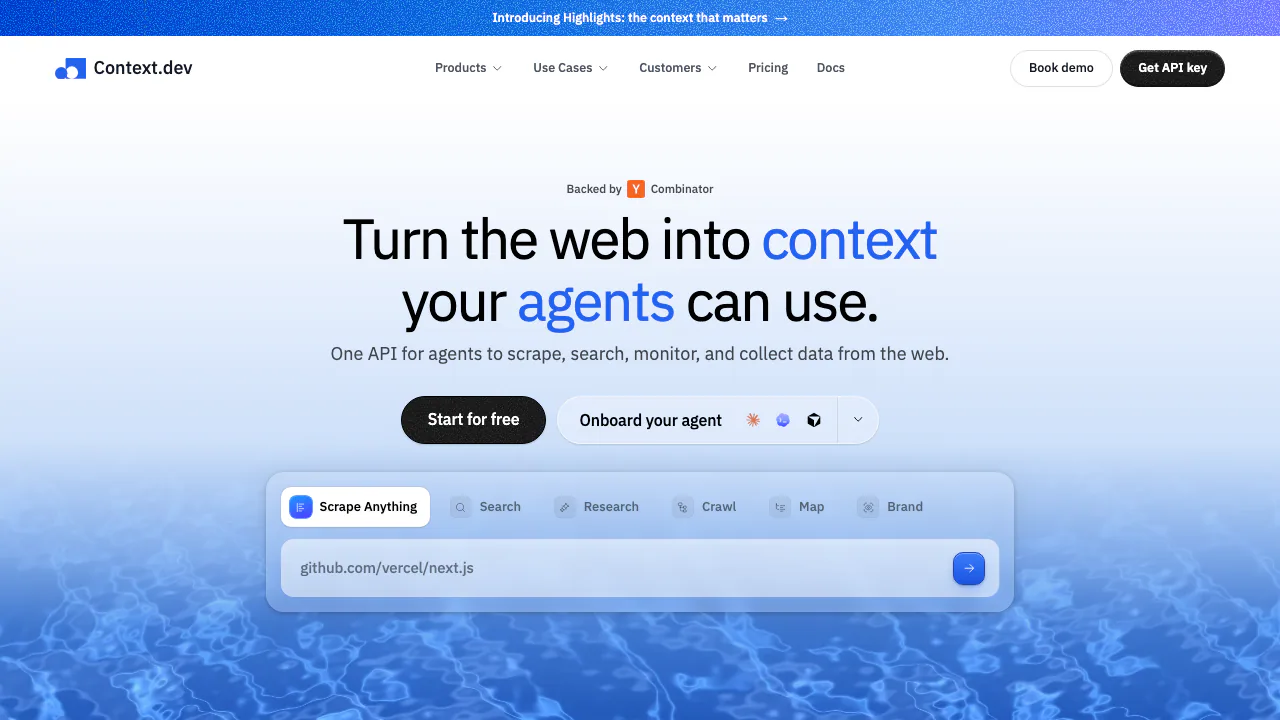
Context.dev: Web Scraping API für KI-Agenten
Webseiten als Markdown und strukturierte Daten abrufen, ganze Websites crawlen und Änderungen überwachen.
Einfach erklärt: Wofür ist Context.dev da?
Context.dev ist eine Web Scraping API für Anwendungen, die Inhalte aus dem Internet benötigen. Ihr Programm übergibt eine URL und erhält beispielsweise Markdown, gerendertes HTML, Screenshots oder strukturierte Felder zurück. Der Anbieter übernimmt dabei Browserbetrieb und Proxy-Infrastruktur. Markdown bewahrt eine lesbare Textstruktur, die sich gut als Eingabe für KI-Anwendungen eignet.
Das Angebot von Context Dev Inc. richtet sich an Entwickler von KI-Agenten, Rechercheanwendungen und RAG-Pipelines. Bei RAG werden vor einer Antwort passende Quellen abgerufen. Context.dev liefert dafür Webinhalte; Speicherung, Indexierung und die eigentliche Anwendung bleiben Ihre Aufgabe.
Passende Daten statt einer kompletten Browser-Infrastruktur
Mit Scrape lesen Sie eine bekannte Seite und wählen die benötigten Ausgabeformate. Für vorgegebene Felder lässt sich eine JSON-Schema-Extraktion einsetzen. JavaScript-Rendering und Proxys sind im Basispreis enthalten, zusätzliche Aktionen können den Credit-Verbrauch erhöhen.
Für Dokumentationsseiten ist die Kombination aus Map und Crawl sinnvoll: Map findet URLs, anschließend begrenzen Sie den Crawl auf relevante Pfade und eine angemessene Tiefe. Ein Crawl liefert höchstens 500 Seiten als Markdown. Größere URL-Listen oder Websites verarbeiten Batches asynchron, mit Abfrage des Status oder Webhook.
Prüfen Sie zuerst einige typische Seiten auf vollständigen Hauptinhalt und bewahren Sie die Quell-URLs auf. Scrape kann standardmäßig bis zu drei Tage alte Cache-Ausgaben verwenden. Mit maxAgeMs: 0 fordern Sie eine neue Erfassung an.
Recherche und laufende Änderungen
Search findet zu einer Suchanfrage URLs, Titel und Beschreibungen, auf Wunsch mit Markdown. Answers bearbeitet einen Rechercheauftrag und liefert Ergebnisse in einer vorgegebenen beispielhaften JSON-Struktur samt Quellen. Überprüfen Sie wichtige Aussagen anhand dieser Quellen.
Monitors vergleichen eine erste Bestandsaufnahme mit späteren geplanten Abrufen. Möglich sind Textänderungen oder relevante Änderungen gemäß Ihren Anweisungen. Kontrollieren Sie den erfolgreichen Basislauf, prüfen Sie Webhook-Signaturen und berücksichtigen Sie fehlgeschlagene Läufe. Die erste Bestandsaufnahme erzeugt noch keine Änderungsmeldung.
Für personalisierte Produktabläufe liefert Brand außerdem Unternehmensdaten, Logos und Farben zu einer Domain. Styleguide ergänzt Schriftgestaltung, Abstände und Komponentenstile.
Einen ersten Abruf durchführen
- Konto erstellen und einen geheimen API-Schlüssel serverseitig hinterlegen.
- Im offiziellen Schnellstart cURL oder ein SDK für TypeScript, Python, Ruby, Go oder PHP wählen.
POST https://api.context.dev/v1/web/scrapemit Bearer-Authentifizierung,urlundformats: { "markdown": true }senden.sharedParams.mainContentOnlykann den Hauptinhalt eingrenzen.- Vor dem Lesen von
markdown.dataden Wertmarkdown.successprüfen. HTTP 200 garantiert keine erfolgreiche Ausgabe in jedem angeforderten Format. - Erst nach der Stichprobe den Umfang vergrößern.
Die MCP-Anleitung beschreibt die Verbindung kompatibler Clients mit https://mcp.context.dev/mcp über OAuth. Dabei werden die Credits der verbundenen Organisation genutzt.
Kostenlos testen und Kosten richtig einschätzen
Stand 15. Oktober 2026 bietet Free monatlich 1.000 API-Credits ohne Kreditkarte. Die öffentlichen monatlichen USD-Preise betragen 19 für Developer, 99 für Pro, 299 für Growth und 499 für Scale. Enthalten sind entsprechend 7.500, 125.000, 500.000 und 1.000.000 Credits pro Monat; Enterprise wird individuell angeboten. Jahresabrechnung und konkrete Bedingungen stehen auf der Preisseite. Es handelt sich nicht um Euro-Endpreise.
Ein Standard-Scrape beginnt bei einem Credit. Browseraktionen erhöhen die Basis auf zwei; erfolgreiche JSON-Extraktion kostet zusätzlich vier. Logo Link hat ein eigenes Kontingent, bei Free einmalig 10.000 Abrufe. Teilweise erfolgreiche Antworten und Zielseiten mit 404 können berechnet werden. Aktiviertes Auto-Topup kann kostenpflichtige Credit-Blöcke hinzufügen; Ausgabenwarnungen sind keine feste Kostensperre. Die tatsächlichen Parallelitäts- und Ratenlimits stehen im Dashboard.
Datenschutz und Nutzungsrechte beachten
Die Datenschutzerklärung erlaubt unter den geltenden Vereinbarungen die Nutzung von Anfragen und Ergebnissen zur Produktverbesserung und zum Modelltraining. Reguläre Aufrufe bedeuten daher keine automatische Nichtaufbewahrung.
Zero Data Retention erfordert eine Freischaltung der Organisation und eine ausdrückliche Einstellung je unterstütztem Aufruf. Prüfen Sie X-Context-ZDR: true. Batches, Monitors und Brand retrieval unterstützen diesen Modus nicht; PDF-OCR wird unter ZDR übersprungen. Eigene Protokolle und Speicher sowie die Rechte an übernommenen Inhalten müssen Sie selbst berücksichtigen.
Häufige Fragen
Ist das Gratis-Kontingent nur eine einmalige Testphase?
Die 1.000 Free-API-Credits werden monatlich bereitgestellt. Das kostenlose Logo-Link-Kontingent von 10.000 Abrufen ist dagegen einmalig und separat.
Muss ich eigene Proxys betreiben?
Rendering und Proxys gehören zum verwalteten Scrape-Angebot. Prüfen Sie trotzdem Ihre Zielseiten; ein bestimmtes Ergebnis wird dadurch nicht für jede Website garantiert.
Wie übernehme ich eine ganze Wissenswebsite?
URLs mit Map eingrenzen, dann bis zu 500 Seiten pro Crawl einlesen. Für größere Mengen Batches nutzen und die Ergebnisse in der eigenen Anwendung speichern.
Bedeutet MCP automatisch mehr Datenschutz?
MCP ist der Verbindungsweg. ZDR ist eine separate Berechtigung mit zusätzlichen Einstellungen und Endpunktgrenzen.
Offizielle Ressourcen
- SDK-Dokumentation: Bibliotheken und Voraussetzungen.
- Dienststatus: Verfügbarkeit prüfen.
- Kontakt: Support und geschäftliche Fragen.
- Offizielles X-Konto: Produktankündigungen.
Ähnliche Tools
KI-Datenbanken & Kontext-Infrastruktur →
CoreSpeedFreemium
App-Zugriffe, dauerhaftes Gedächtnis und Freigaben für vorhandene KI-Agenten.
AIsaKostenpflichtig
Modelle und externe Daten mit einem API-Schlüssel anbinden.
TavilyFreemium
Live-Websuche, Extraktion, Crawling und Recherche für KI-Agenten über eine API
SuperLocalMemoryKostenlos
Projektwissen speichern, gezielt abrufen und zwischen verbundenen Assistenten weiterverwenden.
CrosswalkKostenlos
Newsletter, Feeds und private Notizen im eigenen KI-Assistenten nutzen.