
Retriever AI (rtrvr.ai)Freemium
Convierte tareas del navegador en tablas y procesos que puedes revisar.
Context.dev: API de web scraping para agentes de IA
Obtén Markdown, datos estructurados y capturas de páginas; añade búsqueda y seguimiento de cambios a tus agentes.
En palabras sencillas: ¿para qué sirve Context.dev?
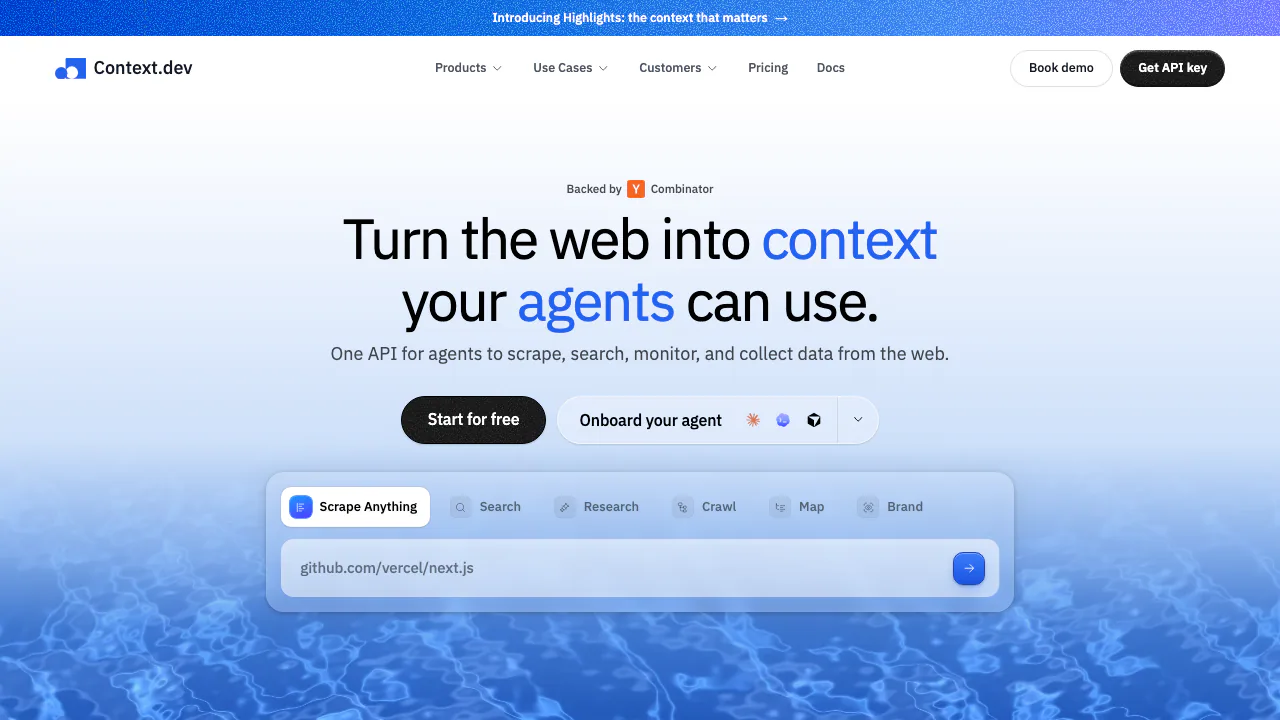
Context.dev es una API de web scraping: tu aplicación envía una dirección web y recibe el contenido en un formato utilizable, como Markdown, HTML renderizado, una captura o campos estructurados. El servicio se encarga de la infraestructura de navegadores y proxies. Markdown conserva títulos y listas en texto legible, algo útil para alimentar aplicaciones de IA.
Context Dev Inc. opera el servicio. Está pensado para desarrolladores de agentes, herramientas de investigación y sistemas RAG, donde la IA consulta fuentes antes de responder. La aplicación sigue siendo responsable de almacenar, indexar y presentar los datos.
Extraer una página o recopilar un sitio completo
Scrape trabaja con una URL conocida y permite solicitar varios formatos. Si necesitas campos específicos, la extracción JSON puede ajustarse a un JSON Schema. El renderizado de JavaScript y los proxies están incluidos en el precio base, aunque ciertas opciones aumentan el consumo.
Para recopilar documentación, utiliza Map para descubrir las URL y selecciona las rutas pertinentes. Después ejecuta Crawl con límites de páginas y profundidad: devuelve Markdown de hasta 500 páginas por llamada. Batches procesa listas o sitios mayores en segundo plano; recupera sus resultados mediante consultas de estado o webhook.
Antes de indexar un sitio en un RAG, revisa unas páginas representativas y conserva las URL de origen. Scrape puede reutilizar salidas almacenadas en caché de hasta tres días por defecto. Si necesitas una captura nueva, configura maxAgeMs: 0.
Buscar, investigar y vigilar cambios
Search parte de una consulta y devuelve páginas ordenadas con títulos y descripciones; también puede incluir Markdown. Answers recibe una tarea de investigación y un objeto JSON de ejemplo para devolver hallazgos estructurados con sus fuentes. Los enlaces ayudan a comprobar la respuesta, pero no sustituyen la revisión de información importante.
Monitors establece una línea base y vuelve a comprobar páginas, mapas del sitio o contenido seleccionado según una programación. Puede detectar diferencias textuales o cambios relevantes según instrucciones. Verifica que la línea base se completó, valida la firma de los webhooks y revisa las ejecuciones fallidas. La primera captura no envía una alerta de cambio.
Brand obtiene perfiles de empresa, logotipos y colores a partir de un dominio. Styleguide añade tipografía, espaciado y estilos de componentes para flujos de personalización.
Cómo hacer la primera llamada
- Crea una cuenta y guarda la clave secreta de API en el servidor.
- Sigue el inicio rápido oficial con cURL o un SDK de TypeScript, Python, Ruby, Go o PHP.
- Envía un POST a
https://api.context.dev/v1/web/scrape, con autenticación Bearer, unaurlyformats: { "markdown": true }. Puedes usarsharedParams.mainContentOnlypara centrarte en el contenido principal. - Comprueba
markdown.successantes de leermarkdown.data. Un HTTP 200 puede contener una salida fallida. - Amplía la recopilación después de verificar la muestra.
Para asistentes compatibles, la guía de MCP documenta https://mcp.context.dev/mcp y el acceso mediante OAuth. Las llamadas consumen los créditos de la organización conectada.
Cuánto cuesta y qué significa un crédito
Comprobado el 15 de octubre de 2026: Free incluye 1.000 créditos de API al mes sin tarjeta. Los precios públicos mensuales en USD son Developer 19, Pro 99, Growth 299 y Scale 499. Sus asignaciones mensuales son 7.500, 125.000, 500.000 y 1.000.000 créditos; Enterprise requiere presupuesto. Consulta precios y condiciones actuales para facturación anual y condiciones de compra. No son precios finales en euros.
Scrape empieza en un crédito; con acciones del navegador, la base es dos. La extracción JSON correcta añade cuatro. Por tanto, 1.000 créditos no equivalen necesariamente a 1.000 páginas estructuradas. Logo Link tiene una cuota aparte, con 10.000 solicitudes únicas en Free.
Las respuestas parcialmente correctas y las páginas de destino con 404 pueden facturarse. Auto-Topup, si está activado en un plan de pago, puede añadir bloques de créditos con coste; las alertas de gasto no son un límite estricto. Comprueba los límites efectivos de concurrencia y solicitudes en tu panel.
Privacidad y reutilización del contenido
La política de privacidad permite utilizar consultas y resultados para mejorar el servicio y entrenar modelos, con las restricciones legales y contractuales aplicables. No debes suponer que todas las llamadas tienen retención cero.
ZDR exige una habilitación de la organización y una opción explícita por solicitud compatible. Verifica X-Context-ZDR: true. Batches, Monitors y Brand retrieval no admiten este modo; PDF OCR se omite con ZDR. También debes gestionar tus propios registros y permisos para reutilizar páginas, imágenes o marcas.
Preguntas frecuentes
¿Los 1.000 créditos gratuitos se renuevan?
Sí, la asignación Free es mensual. Los 10.000 usos gratuitos de Logo Link constituyen una cuota independiente y de una sola vez.
¿Cuántas páginas puedo procesar con esos créditos?
Depende de las opciones. Un Scrape básico parte de uno, pero JSON añade cuatro cuando funciona y las acciones del navegador elevan la base.
¿Puede devolver JSON en lugar de texto?
Sí. Scrape permite extracción con JSON Schema. Comprueba el estado de esa salida y valida los campos importantes antes de utilizarlos.
¿Puedo rastrear más de 500 páginas?
Crawl llega a 500 por llamada. Para trabajos mayores, utiliza Batches y recupera los resultados de forma asíncrona.
Recursos oficiales
- SDK oficiales: bibliotecas y requisitos.
- Estado del servicio: comprobar incidencias.
- Contacto: soporte y consultas comerciales.
- Cuenta oficial en X: novedades del producto.
Herramientas relacionadas
Bases de datos e infraestructura de contexto para IA →
CoreSpeedFreemium
Aplicaciones conectadas, memoria persistente y aprobaciones para tus agentes.
AIsaDe pago
Conecta modelos y datos externos con una sola clave API.
TavilyFreemium
Busca, extrae, rastrea e investiga la web actual para agentes de IA mediante una API
SuperLocalMemoryGratis
Guarda decisiones y reglas del proyecto para recuperarlas desde tus asistentes conectados.
CrosswalkGratis
Reúne newsletters, fuentes y notas para consultarlas desde tu asistente.