
Retriever AI (rtrvr.ai)Freemium
Transforme instruções em tarefas de navegação e tabelas que você pode conferir.
Context.dev: API de web scraping para agentes de IA
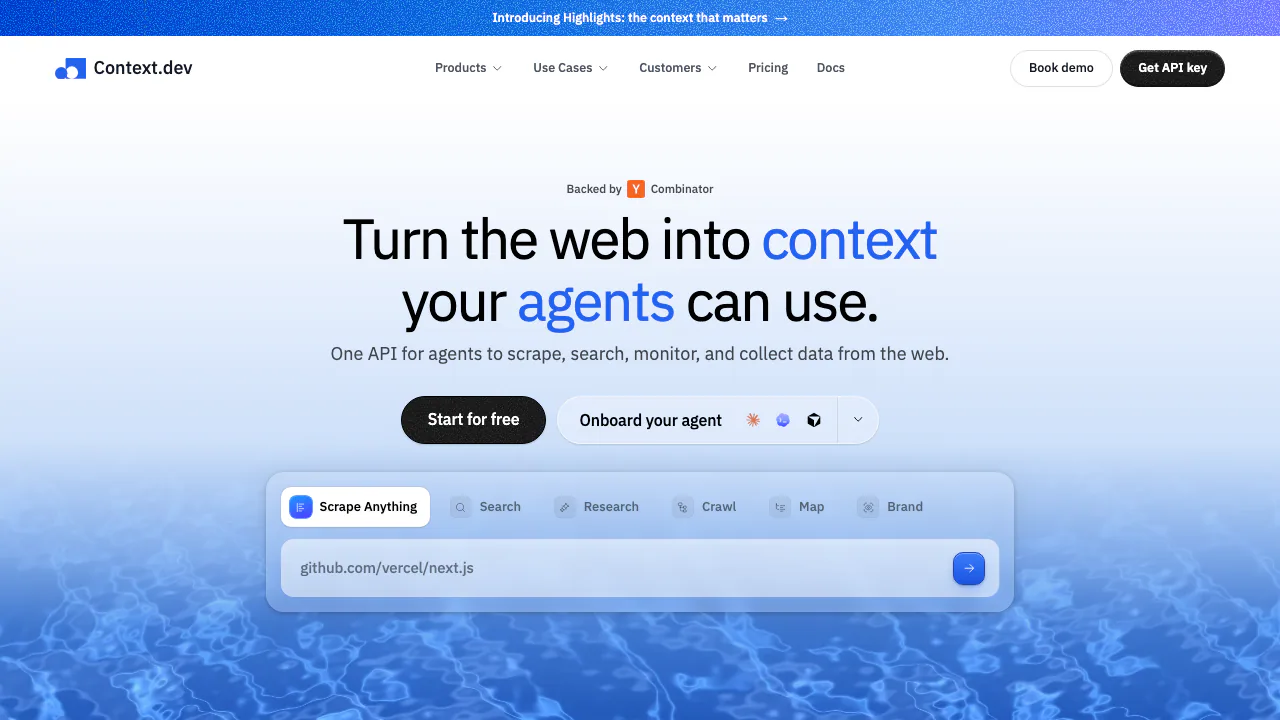
Transforme páginas em Markdown e dados estruturados, pesquise a web e acompanhe mudanças com uma API.
Em linguagem simples: para que serve o Context.dev?
O Context.dev é uma API de web scraping. Seu aplicativo envia uma URL e recebe conteúdo utilizável, como Markdown, HTML renderizado, uma captura de tela ou campos estruturados. O serviço cuida da infraestrutura de navegadores e proxies. Markdown mantém títulos e listas em um texto legível, útil para fornecer fontes a um modelo de IA.
Operado pela Context Dev Inc., atende desenvolvedores de agentes, ferramentas de pesquisa e pipelines RAG. Em RAG, a aplicação busca informações antes de gerar uma resposta. O Context.dev fornece os dados da web; armazenamento, indexação e apresentação continuam na sua aplicação.
Da página aos dados que seu produto precisa
Scrape lê uma URL conhecida e permite combinar formatos. Use Markdown para texto, HTML para a estrutura, screenshot para registrar o visual ou extração JSON com JSON Schema para campos definidos. Renderização JavaScript e proxies entram no preço base, mas certas opções consomem mais créditos.
Para documentação completa, Map encontra as URLs e Crawl percorre os links, retornando até 500 páginas em Markdown por chamada. Defina caminhos, profundidade e quantidade de páginas. Batches processa listas ou sites maiores de forma assíncrona, com consulta de status ou webhook.
Teste algumas páginas antes de alimentar o seu índice RAG e preserve as URLs das fontes. Scrape pode aproveitar saídas em cache de até três dias por padrão. Para uma nova captura, use maxAgeMs: 0.
Pesquisa, respostas com fontes e monitoramento
Search parte de uma consulta e retorna URLs ordenadas, títulos e descrições, opcionalmente com Markdown. Answers recebe uma tarefa e um objeto JSON de exemplo, produzindo resultados estruturados com fontes. Confira os documentos originais quando a informação influenciar decisões.
Monitors cria uma linha de base e verifica mudanças em páginas, sitemaps ou conteúdo selecionado em uma programação. A detecção pode considerar diferenças textuais ou instruções sobre o que importa. Confirme a execução da base, valide assinaturas dos webhooks e acompanhe falhas. A primeira captura não gera aviso de mudança.
Brand recupera dados de empresas, logos e cores por domínio. Styleguide acrescenta tipografia, espaçamento e estilos de componentes, útil para personalizar a entrada de clientes em um produto.
Como começar pelo SDK ou MCP
- Crie uma conta e mantenha a chave secreta da API no servidor.
- No guia inicial oficial, escolha cURL ou SDK TypeScript, Python, Ruby, Go ou PHP.
- Envie um POST para
https://api.context.dev/v1/web/scrape, com autenticação Bearer,urleformats: { "markdown": true }. UsesharedParams.mainContentOnlyquando quiser focar o conteúdo principal. - Verifique
markdown.successantes de usarmarkdown.data. Uma resposta HTTP 200 pode conter uma saída malsucedida. - Amplie o trabalho depois de avaliar uma amostra.
O guia de MCP explica a conexão de clientes compatíveis com https://mcp.context.dev/mcp por OAuth. As chamadas usam os créditos da organização conectada.
Plano grátis e preços em dólares
Verificado em 15 de outubro de 2026: Free oferece 1.000 créditos de API por mês, sem cartão. Os preços públicos mensais em USD são Developer 19, Pro 99, Growth 299 e Scale 499. Os limites mensais são, respectivamente, 7.500, 125.000, 500.000 e 1.000.000 créditos. Enterprise tem orçamento personalizado. Veja a página de preços para cobrança anual e condições; esses valores não são preços em reais.
Um Scrape padrão começa em um crédito; com ações do navegador, a base passa a dois. Extração JSON bem-sucedida acrescenta quatro. Logo Link usa uma cota separada, incluindo 10.000 solicitações únicas no Free. Resultados parcialmente bem-sucedidos e páginas de destino com 404 podem ser cobrados.
Auto-Topup pode adicionar blocos pagos quando habilitado. Alertas de gastos são notificações, não um teto rígido. Confira limites efetivos de concorrência e requisições no painel, principalmente em contas antigas ou personalizadas.
Privacidade e permissão de uso
A política de privacidade permite usar consultas e resultados para melhorar o serviço e treinar modelos, sujeitos às regras e aos contratos aplicáveis. Chamadas comuns não têm retenção zero automaticamente.
ZDR exige habilitação da organização e uma opção explícita em cada chamada compatível. Verifique X-Context-ZDR: true. Batches, Monitors e Brand retrieval não oferecem esse modo; PDF OCR é ignorado com ZDR. Você também precisa gerenciar seus próprios logs e os direitos de reutilização de páginas, imagens e marcas.
Perguntas frequentes
Preciso manter proxies e navegadores?
Essa infraestrutura é gerenciada pela plataforma e incluída na base do Scrape. Ainda é necessário testar as páginas reais e verificar os resultados.
Quais formatos de saída posso escolher?
Entre os formatos estão Markdown, HTML, screenshots e JSON com esquema. Cada saída tem seu próprio estado de sucesso.
O plano gratuito precisa de cartão?
Não. Ele fornece 1.000 créditos de API por mês, mas o número de páginas varia conforme as operações.
Posso acompanhar alterações de preços?
Monitors pode verificar páginas conforme uma programação e instruções. Confirme a linha de base, trate assinaturas e falhas e dimensione o consumo recorrente.
Recursos oficiais
- SDKs oficiais: bibliotecas e requisitos.
- Status do serviço: disponibilidade.
- Contato: suporte e demandas comerciais.
- Perfil oficial no X: anúncios do produto.
Ferramentas parecidas
Bancos de dados e infraestrutura de contexto para IA →
CoreSpeedFreemium
Integrações, memória persistente e aprovações para os agentes que você já usa.
AIsaPago
Uma chave API para modelos, pesquisa e fontes de dados externas.
TavilyFreemium
Pesquise, extraia, rastreie e investigue a web atual para agentes de IA por uma API
SuperLocalMemoryGrátis
Guarde decisões e regras de projeto para reutilizar o contexto nos seus assistentes conectados.
CrosswalkGrátis
Reúna newsletters, fontes e notas para consultar no seu próprio assistente.