
Retriever AI (rtrvr.ai)Есть бесплатный тариф
Описывайте задачи в браузере и проверяйте готовые таблицы и действия.
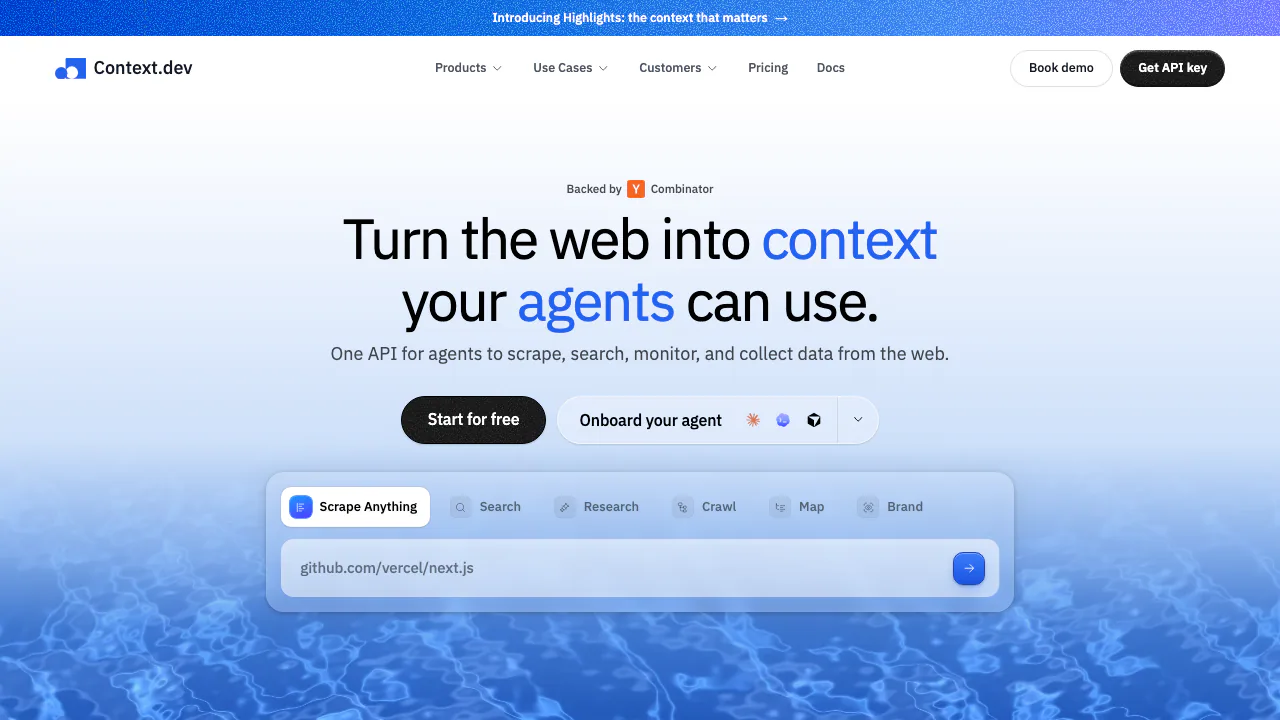
Context.dev — API для парсинга сайтов и AI-агентов
Получайте содержимое страниц, результаты поиска и изменения сайтов через единый API для AI-приложений.
Базы данных и контекстная инфраструктура для ИИЕсть бесплатный тарифAPI веб-поиска и парсинга для ИИ
Простыми словами: для чего нужен Context.dev?
Context.dev — API для парсинга сайтов. Ваша программа отправляет веб-адрес и получает пригодные для обработки данные: Markdown, отрисованный HTML, скриншот или заданные поля. Сервис берёт на себя браузеры и инфраструктуру прокси. Markdown сохраняет заголовки и списки в читаемом тексте, который удобно передавать модели.
Сервисом управляет Context Dev Inc. Он рассчитан на разработчиков AI-агентов, исследовательских инструментов и RAG-конвейеров. В RAG приложение сначала находит источники, затем готовит ответ. Context.dev получает веб-контент, а хранение, индексирование и интерфейс остаются задачей вашего приложения.
Как собрать документацию для RAG
Для известной страницы используйте Scrape. Можно запросить несколько форматов, включая JSON по JSON Schema. JavaScript-рендеринг и прокси входят в базовую стоимость; дополнительные действия меняют расход кредитов.
Map обнаруживает адреса внутри сайта. Отберите полезные пути и запустите Crawl с ограничениями глубины и числа страниц: один вызов возвращает до 500 страниц Markdown. Для более крупных списков или сайтов есть асинхронный Batches; результаты забирают опросом статуса или через webhook.
Сначала проверьте несколько типичных страниц: содержат ли они нужный текст и ссылки на источники. Затем передавайте материал в собственный индекс. Scrape по умолчанию может использовать результаты из кеша возрастом до трёх дней. Для нового получения страницы задайте maxAgeMs: 0.
Поиск источников и наблюдение за изменениями
Search получает запрос и возвращает ранжированные URL, заголовки и описания, при необходимости с Markdown. Answers принимает исследовательскую задачу и пример JSON-объекта, выдавая структурированный результат со ссылками. Важные выводы следует проверять по исходным страницам.
Monitors создаёт исходный снимок и сравнивает последующие проверки страниц, sitemap или выбранного контента по расписанию. Можно отслеживать текстовые отличия или изменения, значимые по инструкции. Подтвердите завершение базового запуска, проверяйте подписи webhook и неудачные выполнения. Первый снимок не считается уведомлением об изменении.
Brand получает данные компании, логотипы и цвета по домену. Styleguide дополняет их типографикой, отступами и стилями компонентов для персонализации продукта.
Первый запрос и подключение MCP
- Создайте аккаунт и храните секретный API-ключ на сервере.
- По официальному руководству выберите cURL или SDK TypeScript, Python, Ruby, Go либо PHP.
- Отправьте POST на
https://api.context.dev/v1/web/scrapeс Bearer-аутентификацией,urlиformats: { "markdown": true }. Для основного текста можно задатьsharedParams.mainContentOnly. - Перед чтением
markdown.dataпроверьтеmarkdown.success. HTTP 200 может содержать ошибку отдельного формата. - Расширяйте объём после проверки выборки, сохраняя идентификатор запроса для диагностики.
Инструкция MCP описывает подключение совместимых клиентов к https://mcp.context.dev/mcp через OAuth. Вызовы расходуют кредиты подключённой организации.
Бесплатный лимит и стоимость в долларах
Проверено 15 октября 2026 года: Free даёт 1 000 API-кредитов ежемесячно без банковской карты. Публичные месячные цены в USD: Developer — 19, Pro — 99, Growth — 299, Scale — 499. Включено соответственно 7 500, 125 000, 500 000 и 1 000 000 кредитов в месяц. Enterprise рассчитывается индивидуально. Годовая оплата и условия покупки указаны в актуальном прайсе; это не цены в рублях и не подтверждение доступности оплаты в конкретном регионе.
Обычный Scrape начинается с одного кредита; действия браузера повышают базу до двух, успешное извлечение JSON добавляет четыре. Logo Link имеет отдельную квоту, в Free — 10 000 запросов однократно. Частичный успех и ответ целевой страницы 404 могут оплачиваться. Включённый Auto-Topup может добавлять платные блоки; уведомления о расходах не останавливают потребление. Действующие лимиты аккаунта смотрите в панели.
Обработка данных и права на контент
Политика конфиденциальности допускает использование запросов и результатов для улучшения сервиса и обучения моделей в рамках применимых соглашений и ограничений.
Zero data retention требует разрешения организации и явной настройки поддерживаемого вызова. Проверяйте X-Context-ZDR: true. Batches, Monitors и Brand retrieval не поддерживают этот режим; PDF OCR при ZDR пропускается. Собственные журналы и хранилища нужно контролировать отдельно. Доступ API не даёт лицензии на перепубликацию чужих страниц или логотипов.
Частые вопросы
Как забирать большие результаты?
Для крупных заданий используйте Batches и получайте результаты асинхронно через опрос статуса или webhook.
Есть ли бесплатные запросы?
Есть 1 000 API-кредитов в месяц. Это не универсальные 1 000 операций: стоимость зависит от выбранных возможностей.
Почему HTTP 200 не гарантирует полный результат?
Scrape отмечает успех отдельно для каждого формата. Проверяйте его статус и ошибки, а не только код HTTP.
Можно ли увеличить объём обработки?
Платные планы увеличивают кредитный объём. Реальную параллельность и ограничения организации проверяйте в панели; для особых требований есть Enterprise.
Официальные ресурсы
- Документация SDK: библиотеки и требования.
- Статус сервиса: доступность.
- Контакты: поддержка и бизнес-вопросы.
- Официальный X: объявления.
Похожие нейросети
Базы данных и контекстная инфраструктура для ИИ →
CoreSpeedЕсть бесплатный тариф
Подключения, долговременная память и согласование действий для ваших агентов.
AIsaПлатно
Единый ключ API для моделей и внешних источников данных.
TavilyЕсть бесплатный тариф
Ищите, извлекайте и обходите актуальный веб для ИИ-агентов через единый API
SuperLocalMemoryБесплатно
Сохраняйте решения и правила проекта, чтобы подключённые ассистенты находили их в следующих сессиях.
CrosswalkБесплатно
Передавайте рассылки и заметки своему ассистенту и находите их в новых беседах.