
Retriever AI (rtrvr.ai)Freemium
Opisuj zadania w przeglądarce i sprawdzaj uporządkowane wyniki.
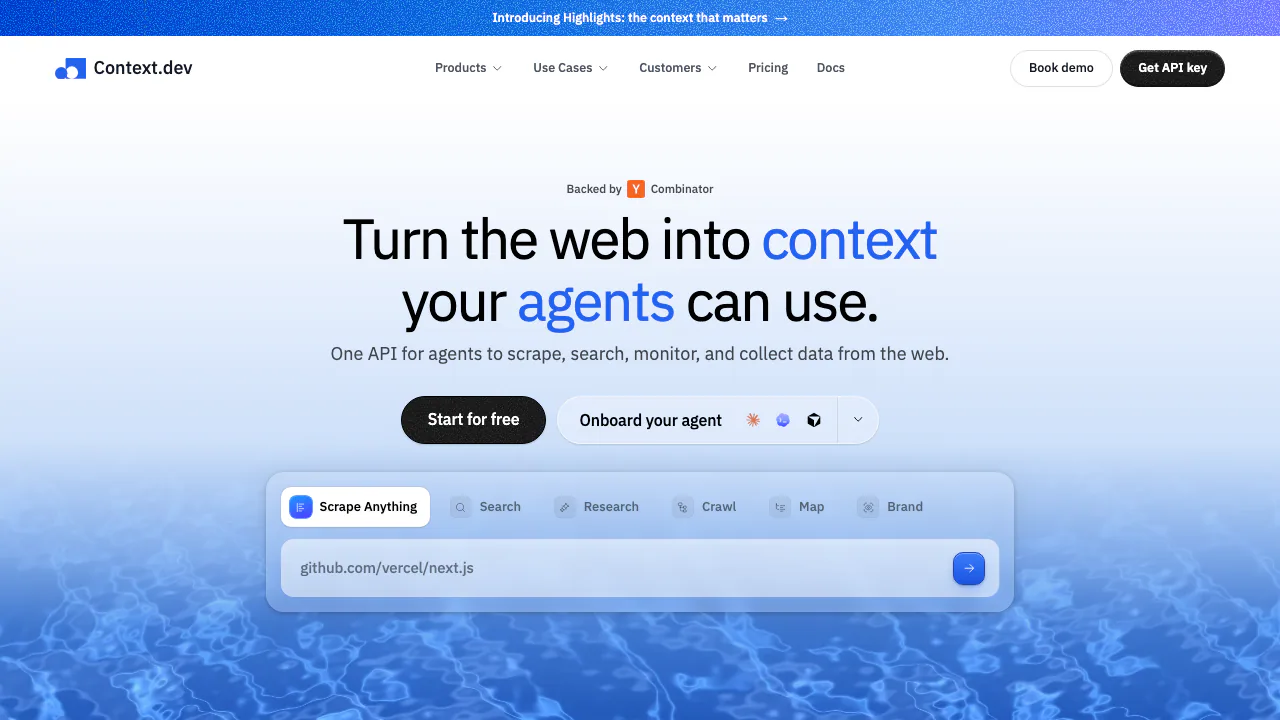
Context.dev: API do web scrapingu dla agentów AI
Pobieraj treści stron, przeszukuj sieć i monitoruj zmiany za pomocą jednego API dla aplikacji AI.
Prosto wyjaśnione: do czego służy Context.dev?
Context.dev to API do web scrapingu, czyli pobierania danych ze stron. Aplikacja przekazuje adres, a usługa zwraca na przykład Markdown, wyrenderowany HTML, zrzut ekranu lub ustrukturyzowane pola. Dostawca zajmuje się przeglądarkami i infrastrukturą proxy. Markdown zachowuje nagłówki oraz listy w czytelnym tekście, przydatnym jako materiał dla modelu AI.
Usługę prowadzi Context Dev Inc. Jest przeznaczona dla programistów agentów AI, narzędzi badawczych i systemów RAG. W RAG aplikacja wyszukuje źródła przed przygotowaniem odpowiedzi. Context.dev dostarcza dane z sieci; przechowywanie, indeksowanie i prezentacja pozostają po stronie Twojego produktu.
Pobieranie pojedynczej strony i dokumentacji
Scrape obsługuje znany URL i wybrane formaty odpowiedzi. Możesz pobrać tekst do analizy, HTML do sprawdzenia struktury, screenshot lub dane według JSON Schema. Renderowanie JavaScript i proxy są wliczone w cenę bazową, lecz dodatkowe opcje mogą zwiększać zużycie kredytów.
Map służy do odkrywania adresów w witrynie. Następnie Crawl podąża za linkami i zwraca do 500 stron Markdown w jednym wywołaniu. Ogranicz liczbę stron, głębokość i ścieżki. Większe zbiory obsłuży Batches w tle, z odpytywaniem statusu lub webhookiem.
Przed zasileniem własnej bazy RAG sprawdź próbkę: czy zawiera właściwy tekst i czy zachowano adres źródłowy. Scrape domyślnie może używać wyników z pamięci podręcznej sprzed maksymalnie trzech dni. Ustaw maxAgeMs: 0, gdy potrzebujesz nowego pobrania.
Jak połączyć API z aplikacją lub agentem
- Załóż konto i umieść tajny klucz API po stronie serwera.
- Wybierz cURL albo SDK TypeScript, Python, Ruby, Go lub PHP w oficjalnym przewodniku.
- Wyślij POST do
https://api.context.dev/v1/web/scrape, podając uwierzytelnianie Bearer,urliformats: { "markdown": true }. OpcjasharedParams.mainContentOnlypomaga ograniczyć wynik do treści głównej. - Przed użyciem
markdown.datasprawdźmarkdown.success. HTTP 200 może zawierać nieudany wynik jednego z formatów. - Rozszerz zakres dopiero po ocenie próbki.
Instrukcja MCP opisuje podłączenie zgodnego klienta do https://mcp.context.dev/mcp przez OAuth. Wywołania zużywają kredyty połączonej organizacji.
Wyszukiwanie, odpowiedzi ze źródłami i monitoring
Search przyjmuje zapytanie i zwraca uporządkowane adresy, tytuły i opisy, opcjonalnie z Markdown. Answers otrzymuje zadanie oraz przykładowy obiekt JSON i przygotowuje ustrukturyzowaną odpowiedź ze źródłami. Ważne ustalenia należy porównać z cytowanymi stronami.
Monitors ustala stan początkowy, a następnie porównuje zaplanowane odczyty stron, map witryny lub wybranych treści. Wykrywa różnice tekstowe albo zmiany istotne według instrukcji. Sprawdź wykonanie pomiaru bazowego, podpisy webhooków i nieudane przebiegi. Pomiar bazowy nie wysyła powiadomienia o zmianie.
Brand pobiera informacje o firmie, logo i kolory na podstawie domeny. Styleguide dodaje typografię, odstępy i style komponentów do personalizacji interfejsu.
Kredyty i ceny: co jest darmowe?
Stan na 15 października 2026 r.: Free zapewnia 1 000 kredytów API miesięcznie bez karty. Publiczne miesięczne ceny w USD wynoszą: Developer 19, Pro 99, Growth 299 i Scale 499. Obejmują odpowiednio 7 500, 125 000, 500 000 i 1 000 000 kredytów miesięcznie. Enterprise ma wycenę indywidualną. Cennik zawiera aktualne warunki i rozliczenia roczne; nie są to ceny w złotych.
Zwykły Scrape zaczyna się od jednego kredytu, a z akcjami przeglądarki od dwóch. Udana ekstrakcja JSON dodaje cztery. Logo Link ma oddzielny limit, w Free jednorazowo 10 000 wywołań. Częściowe sukcesy i docelowe strony 404 mogą być płatne. Włączony Auto-Topup może dokupować bloki kredytów; alert wydatków nie jest twardym limitem kosztów. Rzeczywiste limity konta sprawdź w panelu.
Dane i granice użycia
Polityka prywatności dopuszcza używanie zapytań i wyników do ulepszania usługi oraz trenowania modeli, z uwzględnieniem obowiązujących umów i ograniczeń.
ZDR wymaga uprawnienia organizacji i jawnego ustawienia w obsługiwanym żądaniu. Sprawdź X-Context-ZDR: true. Batches, Monitors i Brand retrieval nie obsługują tego trybu; PDF OCR jest w nim pomijane. Nadal odpowiadasz za własne logi i przechowywanie oraz prawo do ponownego wykorzystania cudzych stron i logo.
Pytania i odpowiedzi
Czy API samo tworzy bazę wiedzy RAG?
Nie. Dostarcza treści, które Twoja aplikacja musi sprawdzić, zapisać i zindeksować.
Czy można zacząć bez płacenia?
Tak, od 1 000 kredytów API miesięcznie w Free. Liczba pobrań zależy od wybranych operacji.
Jak pobrać więcej niż 500 stron?
Użyj Batches do zadania asynchronicznego, a potem odbierz i sprawdź wyniki.
Czy zebrane treści wolno dowolnie publikować?
Dostęp API nie daje licencji na materiały osób trzecich. Uprawnienia do ich użycia trzeba ustalić osobno.
Oficjalne materiały
- SDK: biblioteki i wymagania.
- Status usługi: dostępność.
- Kontakt: wsparcie i sprawy biznesowe.
- Oficjalne konto X: ogłoszenia.
Podobne narzędzia
Bazy danych i infrastruktura kontekstu AI →
CoreSpeedFreemium
Integracje, trwały kontekst i zatwierdzanie działań dla używanych już agentów.
AIsaPłatne
Modele i zewnętrzne dane dostępne przez jeden klucz API.
TavilyFreemium
Wyszukuj, wyodrębniaj, indeksuj i analizuj aktualny web dla agentów AI przez jedno API
SuperLocalMemoryZa darmo
Zachowuj decyzje i reguły projektu, aby podłączeni asystenci mogli odnaleźć je w kolejnych sesjach.
CrosswalkZa darmo
Czytaj newslettery i źródła przez własnego asystenta, zachowując przydatne notatki.