
Retriever AI (rtrvr.ai)Miễn phí một phần
Mô tả công việc trên web rồi kiểm tra bảng dữ liệu và thao tác đã thực hiện.
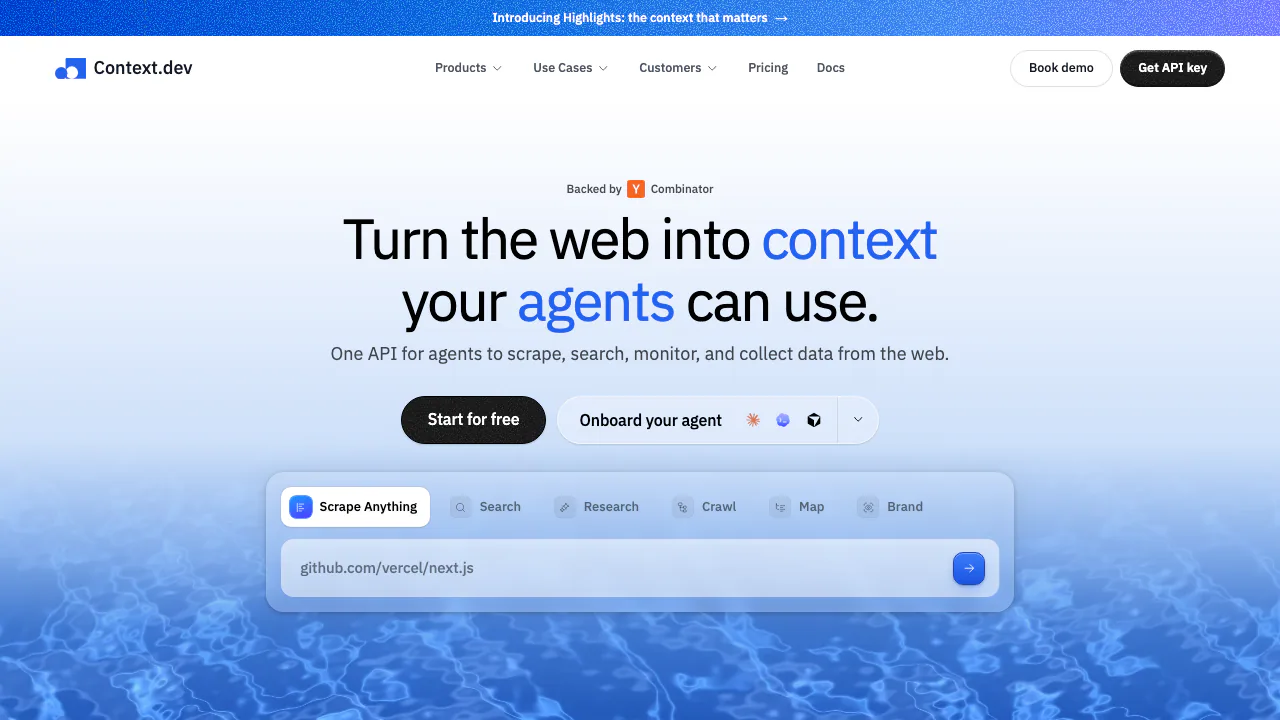
Context.dev: API thu thập dữ liệu web cho AI
Thu thập trang web, tìm nguồn và theo dõi thay đổi bằng một API dành cho ứng dụng và tác nhân AI.
Giải thích dễ hiểu: Context.dev dùng để làm gì?
Context.dev là API thu thập dữ liệu web. Ứng dụng gửi một địa chỉ trang và nhận nội dung có thể xử lý, như Markdown, HTML đã kết xuất, ảnh chụp màn hình hoặc các trường dữ liệu có cấu trúc. Dịch vụ quản lý trình duyệt và hạ tầng proxy. Markdown giữ tiêu đề, danh sách trong văn bản dễ đọc, phù hợp để đưa tài liệu vào mô hình AI.
Dịch vụ do Context Dev Inc. vận hành, dành cho lập trình viên xây tác nhân AI, công cụ nghiên cứu và quy trình RAG. RAG tìm tài liệu liên quan trước khi tạo câu trả lời. Context.dev cung cấp dữ liệu web; ứng dụng của bạn vẫn phụ trách lưu trữ, lập chỉ mục và trình bày kết quả.
Từ URL đầu tiên đến đầu ra đã kiểm tra
- Tạo tài khoản và giữ khóa API bí mật ở máy chủ.
- Chọn cURL hoặc SDK TypeScript, Python, Ruby, Go hay PHP trong hướng dẫn bắt đầu chính thức.
- Gửi POST đến
https://api.context.dev/v1/web/scrapevới xác thực Bearer,urlvàformats: { "markdown": true }. Có thể dùngsharedParams.mainContentOnlyđể tập trung vào nội dung chính. - Kiểm tra
markdown.successtrước khi dùngmarkdown.data. HTTP 200 vẫn có thể chứa một đầu ra lỗi; hãy giữ ID yêu cầu để chẩn đoán. - Chỉ tăng phạm vi sau khi xem xét vài trang đại diện.
Scrape cho phép yêu cầu nhiều định dạng cùng lúc, gồm JSON theo JSON Schema. Kết xuất JavaScript và proxy nằm trong giá cơ bản; thao tác trình duyệt và một số đầu ra làm tăng tín dụng sử dụng.
Với công cụ tương thích, tài liệu MCP mô tả kết nối OAuth đến https://mcp.context.dev/mcp. Lệnh gọi dùng tín dụng của tổ chức được kết nối.
Thu thập cả website và chuẩn bị dữ liệu RAG
Map phát hiện URL trong một website. Chọn đường dẫn cần thiết rồi dùng Crawl để theo các liên kết và nhận tối đa 500 trang Markdown mỗi lần gọi. Hãy giới hạn số trang, độ sâu và đường dẫn. Batches xử lý danh sách hoặc website lớn hơn ở chế độ bất đồng bộ, lấy kết quả qua kiểm tra trạng thái hoặc webhook.
Kiểm tra xem mẫu có đúng nội dung chính, giữ URL nguồn rồi mới chuyển vào chỉ mục riêng. Scrape có thể dùng đầu ra trong bộ nhớ đệm tối đa ba ngày theo mặc định. Dùng maxAgeMs: 0 khi cần lấy bản mới. Thu thập trang chưa có nghĩa là đã hoàn thành toàn bộ hệ thống RAG.
Tìm nguồn, nghiên cứu và theo dõi thay đổi
Search nhận truy vấn và trả URL được xếp hạng, tiêu đề, mô tả, có thể kèm Markdown. Answers nhận nhiệm vụ nghiên cứu cùng một đối tượng JSON mẫu rồi trả kết quả có cấu trúc và URL nguồn. Với thông tin quan trọng, cần đọc nguồn gốc để kiểm chứng.
Monitors tạo mốc ban đầu rồi so sánh các lần kiểm tra theo lịch cho trang, sitemap hoặc nội dung được chọn. Có thể theo dõi khác biệt văn bản hoặc thay đổi liên quan theo chỉ dẫn. Xác nhận lần chạy mốc đã xong, kiểm tra chữ ký webhook và theo dõi lần chạy lỗi. Mốc đầu tiên không phát thông báo thay đổi.
Brand lấy thông tin doanh nghiệp, logo và màu sắc từ tên miền. Styleguide bổ sung kiểu chữ, khoảng cách và kiểu thành phần để cá nhân hóa quy trình giới thiệu sản phẩm.
Tín dụng miễn phí và mức giá USD
Đã kiểm tra ngày 15 tháng 10 năm 2026: Free có 1.000 tín dụng API mỗi tháng, không cần thẻ. Giá công khai theo tháng bằng USD là Developer 19, Pro 99, Growth 299 và Scale 499. Tín dụng tháng tương ứng là 7.500, 125.000, 500.000 và 1.000.000. Enterprise báo giá riêng. Xem giá hiện tại cho thanh toán năm và điều kiện mua; đây không phải giá bằng đồng Việt Nam.
Scrape thường bắt đầu từ một tín dụng; thao tác trình duyệt nâng mức cơ bản lên hai. Trích xuất JSON thành công cộng thêm bốn. Logo Link có hạn mức riêng, gồm 10.000 yêu cầu một lần ở Free. Kết quả thành công một phần và trang đích 404 có thể bị tính phí.
Auto-Topup khi bật có thể thêm các khối tín dụng trả phí. Cảnh báo chi tiêu không phải trần cứng. Xem giới hạn tốc độ và số yêu cầu đồng thời thực tế trong bảng điều khiển của tổ chức.
Dữ liệu được xử lý như thế nào?
Chính sách quyền riêng tư cho phép dùng truy vấn và kết quả để cải thiện dịch vụ, huấn luyện mô hình trong phạm vi thỏa thuận và hạn chế áp dụng. Yêu cầu thông thường không tự động có chế độ không lưu dữ liệu.
ZDR cần quyền tổ chức và thiết lập rõ ràng trong từng yêu cầu được hỗ trợ. Kiểm tra X-Context-ZDR: true. Batches, Monitors và Brand retrieval không hỗ trợ chế độ này; PDF OCR bị bỏ qua khi dùng ZDR. Bạn vẫn cần quản lý nhật ký, lưu trữ của ứng dụng và quyền tái sử dụng tài liệu, hình ảnh, logo của bên thứ ba.
Câu hỏi thường gặp
HTTP thành công có nghĩa là mọi đầu ra đã xong không?
Không. Scrape có trạng thái riêng cho từng định dạng. Kiểm tra success và thông tin lỗi trước khi dùng dữ liệu.
Có thể bắt đầu miễn phí không?
Có, Free cung cấp 1.000 tín dụng API hàng tháng. Số trang thực tế phụ thuộc vào thao tác và tùy chọn.
Nên dùng Markdown hay JSON?
Markdown phù hợp khi cần văn bản để đọc hoặc lập chỉ mục. JSON theo schema phù hợp khi ứng dụng cần những trường xác định.
Cách lấy kết quả của công việc lớn là gì?
Dùng Batches chạy bất đồng bộ, sau đó kiểm tra trạng thái hoặc nhận webhook và thu nhận kết quả.
Tài nguyên chính thức
- Tài liệu SDK: thư viện và yêu cầu tích hợp.
- Trạng thái dịch vụ: kiểm tra khả dụng.
- Liên hệ: hỗ trợ và yêu cầu kinh doanh.
- Tài khoản X chính thức: thông báo sản phẩm.
Công cụ liên quan
Cơ sở dữ liệu và hạ tầng ngữ cảnh AI →
CoreSpeedMiễn phí một phần
Kết nối ứng dụng, bộ nhớ lâu dài và phê duyệt cho agent bạn đang dùng.
AIsaTrả phí
Một khóa API để kết nối mô hình và nguồn dữ liệu cho AI Agent.
TavilyMiễn phí một phần
Tìm kiếm, trích xuất, crawl và nghiên cứu web mới nhất cho tác nhân AI qua một API
SuperLocalMemoryMiễn phí
Lưu quyết định và quy tắc dự án để các trợ lý AI đã kết nối có thể tìm lại khi cần.
CrosswalkMiễn phí
Đưa bản tin, nguồn tin và ghi chú vào trợ lý AI bạn đang sử dụng.