
EarnoteFreemium
Aufnahmen in strukturierte Notizen, Aufgaben, Lernkarten und PDF-Lernzettel verwandeln.
SuperLocalMemory — ein lokales Gedächtnis für KI-Agenten
Projektwissen speichern, gezielt abrufen und zwischen verbundenen Assistenten weiterverwenden.
Was macht SuperLocalMemory einfach erklärt?
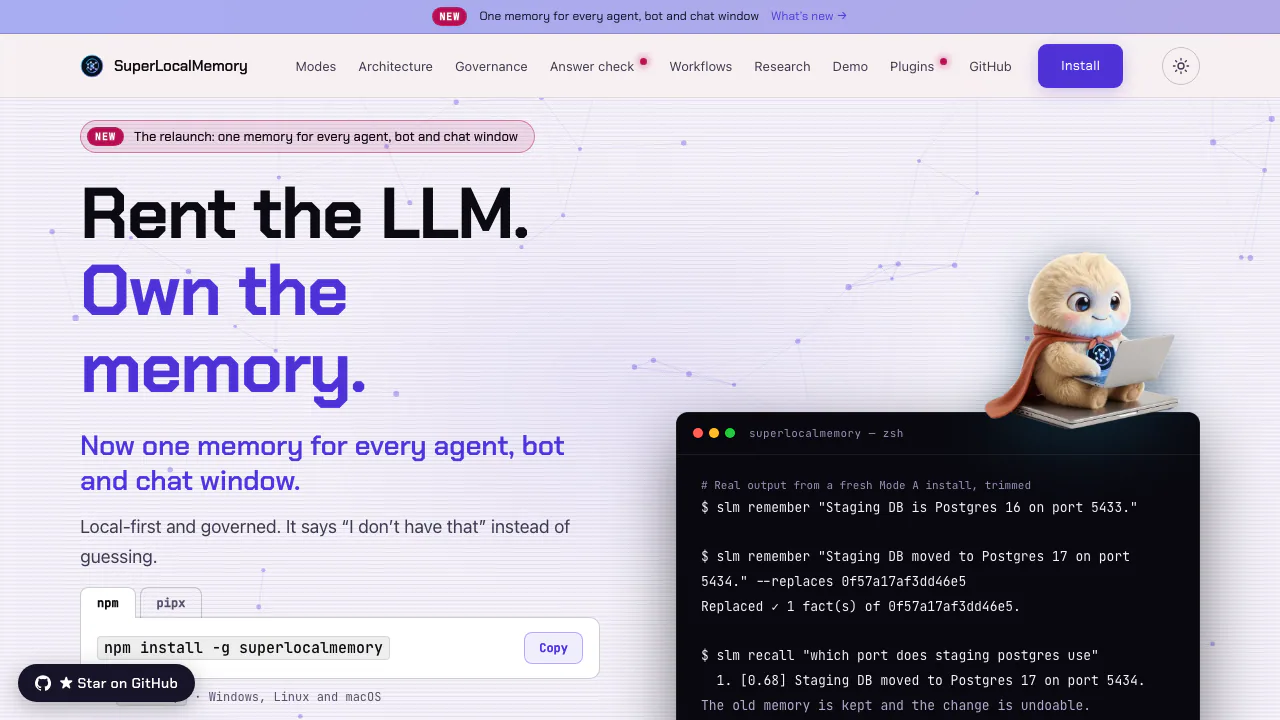
SuperLocalMemory von Qualixar ist ein quelloffenes Gedächtnis für KI-Agenten. Stellen Sie sich ein durchsuchbares Projektnotizbuch vor, auf das Ihre verbundenen Assistenten zugreifen können. Eine technische Entscheidung wird gespeichert und steht bei einer späteren Sitzung wieder zur Verfügung. Das spart wiederholte Erklärungen, wenn Sie zwischen Projekten oder Editoren wechseln.
Das Werkzeug übernimmt Speicherung, Abruf und Verwaltung des Wissens. Es eignet sich besonders für Entwickler und Teams, die langfristig mit KI arbeiten und ihren Speicher selbst betreiben möchten. Installation und eine passende Client-Anbindung bleiben erforderlich.
Lokales Gedächtnis mit klaren Datengrenzen
Mode A verwendet lokale Embeddings für den Kernbetrieb und benötigt dafür keinen generativen Modelldienst. Abhängigkeiten und Modelle müssen zunächst vorhanden sein. Mode B ergänzt Verarbeitung mit Ollama oder einem kompatiblen Endpunkt; lokal ist sie nur, wenn dieser tatsächlich auf dem eigenen Rechner läuft. Mode C kann Fragen und Erinnerungstexte an einen konfigurierten Anbieter senden.
Prüfen Sie deshalb die Betriebsarten und Netzwerkgrenzen. Online-Prüfung, Backups und angeschlossene KI-Anwendungen haben eigene Datenwege. Ein lokaler Speicher macht einen Cloud-Assistenten nicht automatisch lokal. Rollen, Arbeitsbereiche, Aufbewahrung und Audit-Protokolle helfen bei der Verwaltung; sie sind keine rechtliche Zertifizierung.
Entscheidungen behalten und gezielt wiederfinden
Fakten, Regeln und Entscheidungen lassen sich getrennt erfassen. Der Abruf verbindet Bedeutung, Stichwörter, zeitliche Angaben und Zusammenhänge. Filter für Projekte oder Arten von Erinnerungen helfen, die passende Entscheidung statt einer ähnlich formulierten Notiz zu finden.
Ändert sich eine Information, kann ein neuer Eintrag den bisherigen ablösen, ohne dessen Verlauf zu löschen. Geprüfte Korrekturen lassen sich zurücknehmen. Ein hoher Suchwert zeigt jedoch Relevanz und beweist keine sachliche Richtigkeit.
Die erste Erinnerung speichern und prüfen
Die Installationsanleitung nennt Node.js 18+ und npm 9+ für den npm-Weg. Für pipx oder uv gilt Python 3.12–3.14.
- Installieren Sie
npm install -g superlocalmemory. - Starten Sie
slm setupund wählen Sie zunächst Mode A. - Speichern Sie mit
slm remember "Die Testdatenbank verwendet Port 5434."eine unverfängliche Information. - Prüfen Sie sie mit
slm recall "Welchen Port nutzt die Testdatenbank?"und anschließendslm status. - Verbinden Sie Ihren unterstützten Editor, etwa mit
slm connect cursor.
Kontrollieren Sie die tatsächliche Antwort, bevor automatische Erfassung Teil Ihres Arbeitsablaufs wird. Plugins und Hooks werden je nach Client unterschiedlich eingerichtet.
Weitere Assistenten und Dokumente anbinden
CLI, MCP und Client-Integrationen können denselben Speicher nutzen. Optionaler Webzugriff verbindet Anwendungen per OAuth und mit getrennten Lese- beziehungsweise Schreibrechten. Der Rechner muss online bleiben; Anfragen und Ergebnisse laufen über Gateway und Anwendung, obwohl die Datenbank lokal bleibt.
Die optionale Medienindizierung durchsucht unterstützte Bilder und PDF-Seiten mit OCR sowie Datei- und Seitenverweisen. Sie ist zunächst ausgeschaltet und benötigt 16 GB Arbeitsspeicher sowie Modelldownloads. Ordner und Obsidian-Vaults lassen sich mit slm sources add schreibgeschützt einbinden. Die Medienindizierung unterstützt weder Intel-Macs noch Windows auf ARM.
Die Antwortprüfung unterscheidet ähnliche Treffer von ausreichenden Belegen. Laya läuft auf Apple Silicon und benötigt ungefähr 1,1 GB Download. Jev arbeitet optional online mit eigenem Schlüssel und Zustimmung: normalerweise werden Frage und drei Erinnerungen übertragen, bei zusätzlicher Neusortierung bis zu zwanzig. Das reduziert keine Fehler auf garantiert null.
Kosten, Lizenz und Geräteanforderungen
Stand 18. Oktober 2026 ist der lokale Kern kostenlos und unter AGPL v3 verfügbar. Webzugriff enthält ein tägliches Kontingent je Verbindung; eine verlässlich bezifferte allgemeine Grenze wurde nicht bestätigt. Modellanbieter, Jev und KI-Clients können separat abrechnen.
Vorgefertigte Installationen unterstützen Apple-Silicon-Macs sowie 64-Bit-Windows und 64-Bit-Linux. Für Intel-Macs und 32-Bit-Windows gibt es keine solche Installation. Beachten Sie bei Weitergabe und Betrieb die Lizenz im Repository.
Häufige Fragen
Funktioniert das Gedächtnis offline?
Der Kern von Mode A kann nach Vorbereitung der Modelle lokal arbeiten. Webzugriff und externe Dienste benötigen eine Verbindung; das gilt gegebenenfalls auch für Ihren Assistenten.
Brauche ich einen API-Schlüssel?
Nicht für den lokalen Kern von Mode A. Für Jev oder konfigurierte Cloud-Anbieter sind eigene Zugangsdaten und gegebenenfalls Nutzungskosten erforderlich.
Können mehrere Assistenten dieselben Erinnerungen verwenden?
Ja, über unterstützte Integrationen oder MCP. Wählen Sie den passenden Arbeitsbereich und testen Sie einen Eintrag über beide Clients, bevor Sie wichtige Abläufe darauf aufbauen.
Offizielle Ressourcen
- Quellcode und Dokumentation: Lizenz, Integration und Fehlerberichte.
- Beispiele für tägliche Abläufe: Speichern, Abrufen und Korrigieren.
- Details zur Antwortprüfung: Laya, Jev und übertragene Daten.
Ähnliche Tools
KI-Datenbanken & Kontext-Infrastruktur →
NitroStackFreemium
TypeScript-Framework, visuelle Tests und Hosting für eigene MCP-Werkzeuge.
ParrotKostenlos
Gespräche aufnehmen, lokal transkribieren und Vereinbarungen anhand der Originalstellen prüfen.
CopilotKitFreemium
Open-Source-SDK für Chat, App-Aktionen, gemeinsame Zustände und menschliche Freigaben.
guilds.runKostenlos
Agententeams betreiben, Abläufe prüfen und Aufgaben verbessern.
BevelAuf Anfrage
KI-Agenten entwickeln und betreiben lassen; mit Hexis Wissen, Skills und Werkzeuge gemeinsam verwalten.