
EarnoteFreemium
Transformez les enregistrements en notes structurées, tâches, fiches de révision et PDF.
SuperLocalMemory — une mémoire persistante pour agents IA
Retrouvez les décisions et règles de vos projets dans vos différents assistants connectés.
À quoi sert SuperLocalMemory, concrètement ?
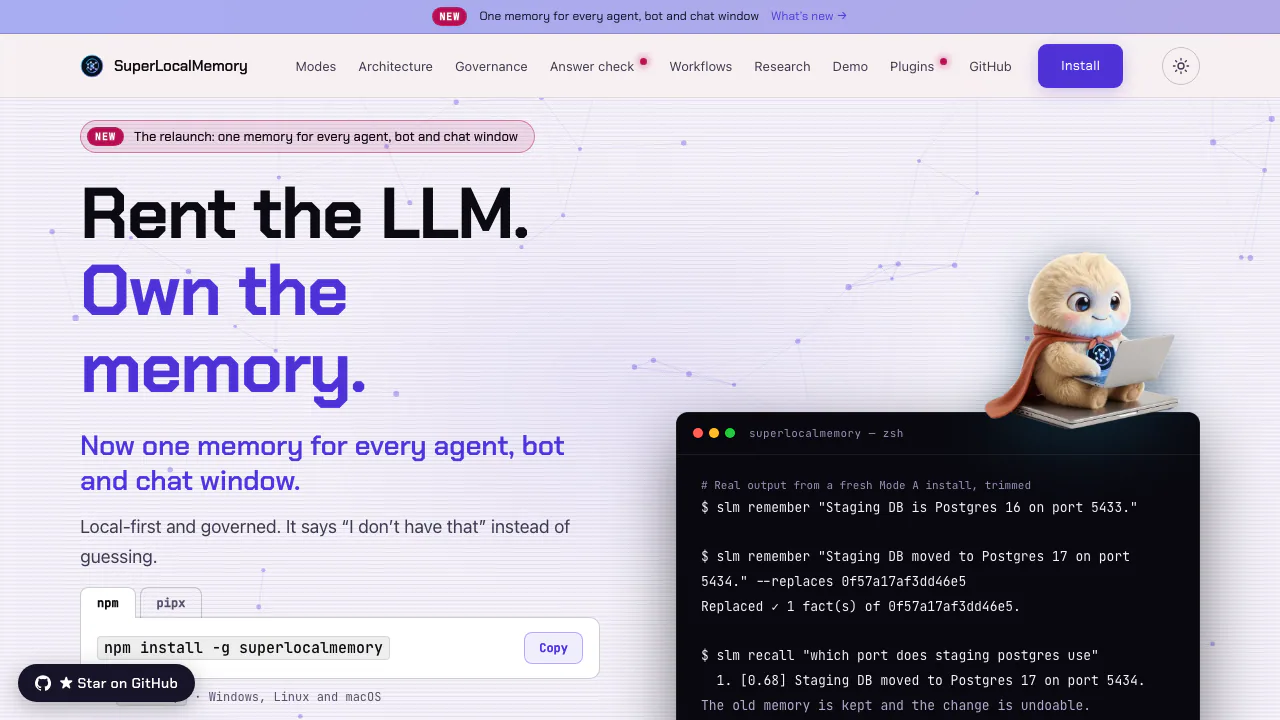
SuperLocalMemory est un système de mémoire open source proposé par Qualixar. Imaginez un carnet de projet consultable par vos assistants IA : vous y enregistrez une décision, puis un assistant connecté la retrouve lors d'une autre session. Vous avez ainsi moins de contexte à répéter lorsque vous reprenez un travail ou changez d'éditeur.
L'outil s'adresse surtout aux développeurs et aux équipes qui souhaitent conserver leurs connaissances de projet et maîtriser leur stockage. Il fournit la mémoire, la recherche et les corrections autour de l'assistant. Il faut l'installer et configurer un client qui utilise effectivement ses outils.
Choisir le traitement local et contrôler les sorties
Mode A utilise des embeddings locaux sans service de modèle génératif pour les opérations essentielles. Il faut néanmoins préparer les dépendances et télécharger les modèles. Mode B ajoute un modèle via Ollama ou un endpoint compatible ; le traitement reste local uniquement si cet endpoint fonctionne sur votre machine. Mode C peut transmettre les questions et les textes mémorisés au fournisseur configuré.
Consultez les frontières réseau des trois modes. Les assistants cloud, sauvegardes et fonctions en ligne ont leurs propres échanges. Les rôles, espaces de travail, durées de conservation et journaux d'audit apportent des contrôles techniques, sans constituer une certification de conformité.
Retrouver le contexte utile entre deux sessions
Les informations peuvent être organisées en faits, règles, décisions ou procédures. La recherche combine sens, mots-clés, temporalité et relations. Des filtres par projet ou type de mémoire évitent de confondre deux notes similaires issues de travaux différents.
Une information devenue obsolète peut être remplacée tout en conservant son historique. Les corrections examinées peuvent être annulées ; les requêtes temporelles distinguent la date d'un événement de celle de son enregistrement. Le score d'un résultat indique sa pertinence, sans certifier son exactitude.
Démarrer avec une première mémoire vérifiable
Le guide d'installation indique Node.js 18+ et npm 9+ pour la voie npm. Les installations avec pipx ou uv utilisent Python 3.12–3.14.
- Exécutez
npm install -g superlocalmemory. - Lancez
slm setupet choisissez Mode A pour commencer en local. - Enregistrez une donnée de test avec
slm remember "La base de test utilise le port 5434.". - Posez
slm recall "Quel port utilise la base de test ?"et vérifiez le contenu retrouvé. - Consultez
slm status, puis reliez votre éditeur, par exemple avecslm connect cursor.
Ce test permet de valider le parcours avant de compter sur une capture automatique. Les plugins, hooks et paramètres MCP varient selon le client.
Vérifier les réponses et retrouver des documents
La vérification des réponses examine si les souvenirs retrouvés répondent réellement à la question. Laya fonctionne sur Apple Silicon après un téléchargement d'environ 1,1 Go. Jev est une option en ligne qui demande votre clé et votre accord : elle transmet habituellement la question et trois souvenirs, jusqu'à vingt avec le reclassement facultatif. Ce contrôle ne garantit pas une absence totale d'erreurs.
L'indexation multimédia optionnelle retrouve des images compatibles et des pages PDF avec OCR et références au fichier et à la page. Désactivée au départ, elle nécessite 16 Go de mémoire et des modèles supplémentaires. Les dossiers et coffres Obsidian peuvent être repris en lecture seule avec slm sources add. L’indexation multimédia ne prend pas en charge les Mac Intel ni Windows sur ARM.
Partager avec ses outils et comprendre les coûts
MCP et les intégrations permettent aux clients compatibles de réutiliser le même stockage. Web access ajoute des applications avec OAuth et des droits distincts de lecture ou d'écriture. Votre ordinateur doit rester connecté ; les appels et leurs résultats traversent une passerelle puis l'application, même si la base demeure locale.
Vérification du 18 octobre 2026 : le cœur local est gratuit sous AGPL v3. L'accès web prévoit une allocation quotidienne par connexion, sans quantité générale confirmée dans les pages consultées. Les fournisseurs de modèles, Jev et les assistants peuvent être facturés séparément. Les installations précompilées concernent Apple Silicon, Windows 64 bits et Linux 64 bits ; elles ne couvrent pas les Mac Intel ni Windows 32 bits.
Questions fréquentes
Peut-on utiliser la mémoire hors ligne ?
Oui pour le cœur de Mode A après préparation des modèles. L'accès web, les fournisseurs externes et éventuellement votre assistant nécessitent une connexion.
Une clé API est-elle obligatoire ?
Pas pour le cœur local de Mode A. Jev et les fournisseurs cloud utilisent vos identifiants et peuvent entraîner une facturation indépendante.
Plusieurs assistants peuvent-ils partager la même mémoire ?
Oui, via leurs intégrations compatibles ou MCP. Choisissez le profil et les permissions, puis testez l'enregistrement dans un client et la récupération dans un autre.
Ressources officielles
- Code source et documentation : licence, intégrations et suivi des problèmes.
- Exemples de travail quotidien : enregistrer, corriger et retrouver des informations.
- Fonctionnement de la vérification des réponses : Laya, Jev et limites de transmission.
Outils similaires
Bases de données et infrastructure de contexte IA →
NitroStackFreemium
Un SDK TypeScript, des tests visuels et un hébergement pour vos outils MCP.
ParrotGratuit
Enregistrez la conversation, retrouvez les décisions et vérifiez le rapport dans les paroles d’origine.
CopilotKitFreemium
Un SDK open source pour relier conversations, interfaces et actions à vos agents.
guilds.runGratuit
Faites travailler des agents ensemble et examinez chaque exécution.
BevelSur devis
Des agents IA construits et maintenus dans votre infrastructure, avec Hexis pour les connaissances partagées.