
EarnoteFreemium
Convierte clases y reuniones en notas, tareas, tarjetas de estudio y PDF en dispositivos Apple.
SuperLocalMemory — memoria persistente para agentes de IA
Guarda decisiones y reglas del proyecto para recuperarlas desde tus asistentes conectados.
¿Para qué sirve SuperLocalMemory?
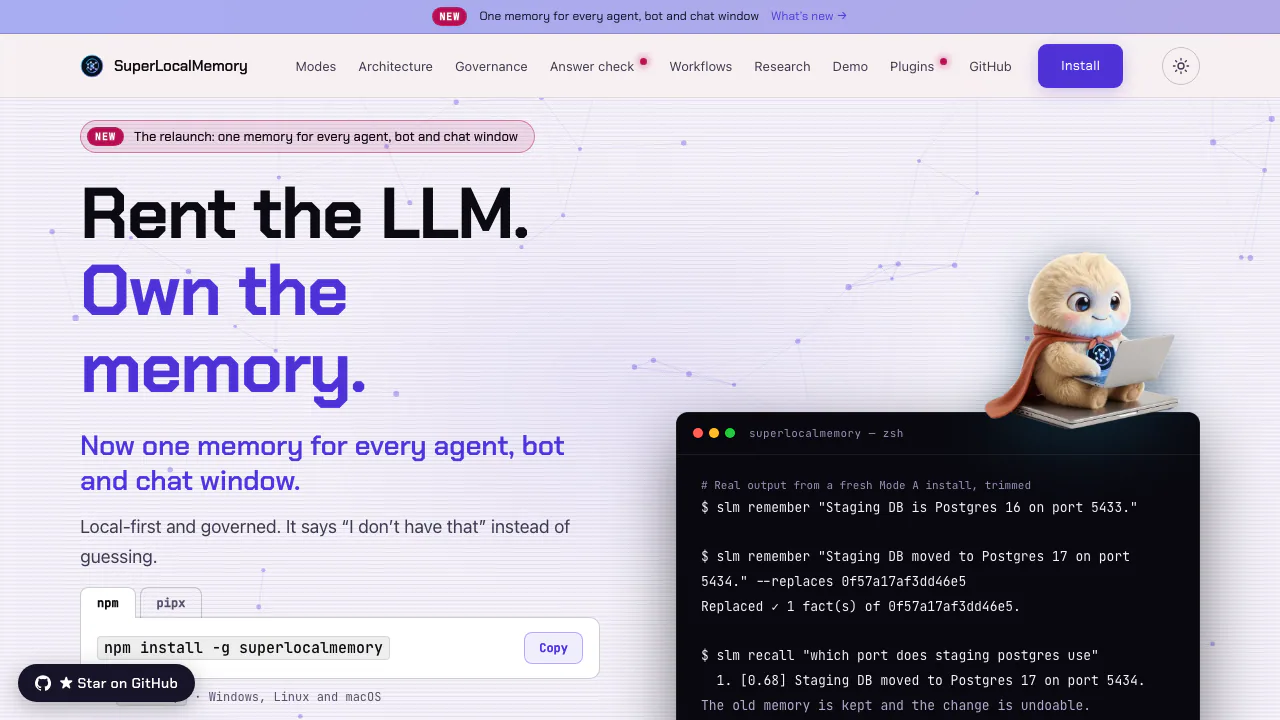
SuperLocalMemory, de Qualixar, es una memoria de código abierto para agentes de IA. Funciona como un cuaderno de proyecto que los asistentes conectados pueden consultar y actualizar. Si guardas una decisión hoy, podrás recuperarla en otra sesión sin volver a explicar todo el historial.
Resulta útil para quienes trabajan con varios editores, mantienen proyectos durante meses o quieren gestionar su propio almacén de contexto. Aporta almacenamiento, búsqueda y control de cambios; requiere instalación y un cliente que utilice sus herramientas de memoria.
Recuperar decisiones sin repetir todo el contexto
Permite guardar hechos, reglas, decisiones y procedimientos. La recuperación combina significado, palabras clave, tiempo y relaciones; los filtros por proyecto o tipo de recuerdo ayudan a localizar el dato adecuado. Así puedes preguntar por una decisión de despliegue sin introducir de nuevo la conversación completa.
Cuando un dato cambia, es posible sustituirlo manteniendo su historial. Las correcciones revisadas admiten reversión, y las consultas temporales permiten distinguir cuándo ocurrió algo y cuándo se registró. La puntuación de un resultado expresa relevancia, no una garantía de que sea correcto.
Guardar el primer recuerdo y conectar el editor
La guía de instalación exige Node.js 18+ y npm 9+ para npm; la alternativa con pipx o uv utiliza Python 3.12–3.14.
- Instala con
npm install -g superlocalmemory. - Ejecuta
slm setupy selecciona Mode A para empezar con el núcleo local. - Guarda un dato de prueba:
slm remember "La base de pruebas utiliza el puerto 5434.". - Recupera el dato con
slm recall "¿Qué puerto utiliza la base de pruebas?"y comprueba la respuesta. - Revisa
slm statusy conecta un editor compatible, por ejemplo conslm connect cursor.
Conviene verificar este recorrido antes de activar capturas automáticas. Cada cliente tiene su propia configuración de plugins, hooks o MCP.
Elegir entre memoria local y proveedores externos
Mode A usa embeddings locales y no necesita un proveedor de modelos generativos para guardar y recuperar recuerdos. Las dependencias y los modelos deben descargarse inicialmente. Mode B añade un modelo mediante Ollama o un endpoint compatible; solo mantiene el procesamiento en el equipo si ese endpoint está allí. Mode C puede enviar consultas y textos guardados al proveedor elegido.
La comparación de modos ayuda a revisar estas diferencias. Un asistente en la nube conserva sus propios flujos de datos aunque la base esté en tu ordenador. Los roles, ámbitos, políticas de conservación y registros de auditoría son controles técnicos, no una certificación legal.
Comprobar respuestas y buscar documentos
La comprobación de respuestas determina si los recuerdos recuperados contestan realmente a la pregunta. Laya funciona en Apple Silicon con una descarga aproximada de 1,1 GB. Jev es opcional, trabaja en línea y necesita tu clave y consentimiento: normalmente envía la pregunta y tres recuerdos; su opción adicional de reordenación puede enviar hasta veinte. Ninguno garantiza una ausencia absoluta de errores.
La indexación multimedia opcional permite localizar imágenes compatibles y páginas PDF con OCR y referencias al archivo y la página. Está desactivada inicialmente, requiere 16 GB de memoria y descargas adicionales. También puedes reflejar carpetas y bóvedas de Obsidian en modo de solo lectura mediante slm sources add. La indexación multimedia no está disponible en Mac Intel ni Windows sobre ARM.
Acceso desde la web, costes y límites
Los clientes compatibles pueden compartir el almacén mediante MCP. Web access añade aplicaciones con OAuth y permisos de lectura o de lectura y escritura. Tu ordenador debe permanecer conectado; las solicitudes y resultados pasan por una pasarela y por la aplicación.
Verificado el 18 de octubre de 2026: el núcleo local es gratuito y utiliza AGPL v3. El acceso web incluye una asignación diaria por conexión, sin una cifra universal confirmada en las páginas consultadas. Los proveedores de modelos, Jev y los propios asistentes pueden generar cargos independientes. Las instalaciones precompiladas cubren macOS con Apple Silicon, Windows de 64 bits y Linux de 64 bits; no Intel Mac ni Windows de 32 bits.
Preguntas frecuentes
¿Se puede utilizar sin Internet?
El núcleo de Mode A funciona localmente una vez preparados los modelos y dependencias. Las funciones web, los proveedores externos y algunos asistentes sí necesitan conexión.
¿Necesito una suscripción o una clave API?
No para el núcleo local de Mode A. Jev y los proveedores externos requieren sus propias credenciales y pueden cobrar por uso.
¿Sirve para varios asistentes a la vez?
Los clientes compatibles pueden reutilizar la misma memoria. Configura el perfil y los permisos, y verifica que una nota guardada desde un cliente se recupere correctamente desde otro.
Recursos oficiales
- Repositorio y documentación: código, licencia e integraciones.
- Ejemplos de uso diario: recuperación, sustitución y acceso web.
- Detalles de Laya y Jev: condiciones y datos enviados.
Herramientas relacionadas
Bases de datos e infraestructura de contexto para IA →
NitroStackFreemium
Convierte tus API en herramientas MCP con TypeScript, pruebas visuales y alojamiento.
ParrotGratis
Graba llamadas, consulta tus documentos y revisa cada acuerdo con su marca de tiempo.
CopilotKitFreemium
SDK de código abierto para conectar conversaciones, componentes y acciones con agentes de IA.
guilds.runGratis
Coordina agentes y revisa sus instrucciones, herramientas y memoria.
BevelPrecio a consultar
Implementación y operación de agentes empresariales con conocimiento, habilidades y herramientas compartidas.