
EarnoteFreemium
Zamieniaj nagrania w notatki, zadania, fiszki oraz materiały PDF na urządzeniach Apple.
SuperLocalMemory — trwała pamięć dla agentów AI
Zachowuj decyzje i reguły projektu, aby podłączeni asystenci mogli odnaleźć je w kolejnych sesjach.
Do czego służy SuperLocalMemory?
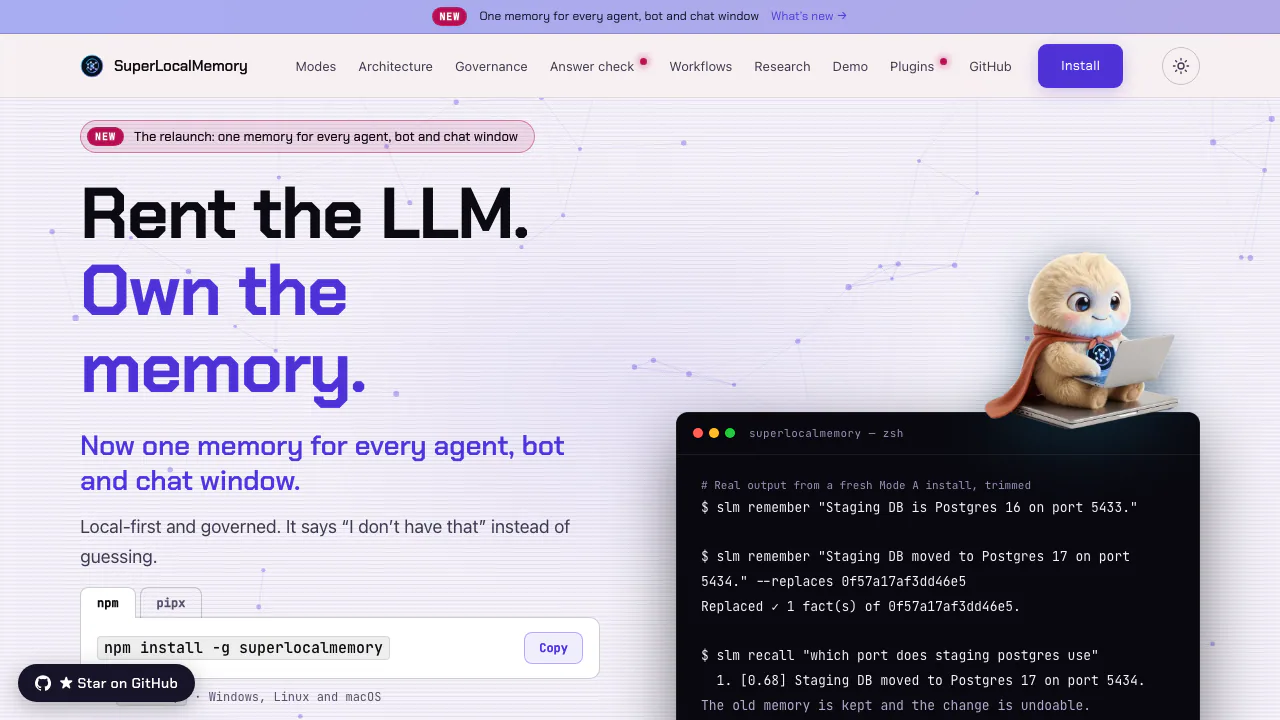
SuperLocalMemory firmy Qualixar to otwartoźródłowa pamięć dla agentów AI. Można ją porównać do przeszukiwalnego notatnika projektu: zapisujesz decyzję, a podłączony asystent odnajduje ją podczas następnej sesji. Ułatwia to powrót do długich zadań bez ponownego tłumaczenia wszystkich ustaleń.
Narzędzie odpowiada za przechowywanie, wyszukiwanie i aktualizowanie kontekstu. Przydaje się programistom oraz zespołom korzystającym z kilku edytorów i chcącym zarządzać własną wiedzą. Wymaga instalacji i klienta, który faktycznie wywołuje narzędzia pamięci.
Kontekst między sesjami i kontrola zmian
Możesz zapisywać fakty, reguły, decyzje i instrukcje. Wyszukiwanie łączy znaczenie, słowa kluczowe, czas i relacje. Filtry projektu oraz rodzaju wpisu pomagają oddzielić właściwe ustalenie od podobnej notatki z innego zadania.
Zmiana faktu nie musi usuwać jego historii. Mechanizm zastępowania wskazuje aktualny wpis, a zatwierdzane korekty można cofnąć. Zapytania czasowe rozróżniają moment zdarzenia i moment poznania go przez system. Wynik podobieństwa oznacza trafność wyszukiwania, nie pewność prawdziwości informacji.
Pierwszy zapis oraz odczyt pamięci
Instrukcja instalacji podaje Node.js 18+ i npm 9+ dla npm. Alternatywy pipx oraz uv wymagają Pythona 3.12–3.14.
- Zainstaluj pakiet:
npm install -g superlocalmemory. - Uruchom
slm setupi wybierz Mode A. - Zapisz bezpieczny fakt testowy:
slm remember "Baza testowa używa portu 5434.". - Zapytaj
slm recall "Jakiego portu używa baza testowa?"i sprawdź odnaleziony tekst. - Uruchom
slm status, a następnie podłącz edytor, na przykładslm connect cursor.
Taki test pozwala ocenić działanie pamięci przed włączeniem automatycznego zapisywania. Konfiguracja pluginów, hooków i MCP zależy od klienta.
Lokalne przetwarzanie i granice prywatności
Mode A używa lokalnych embeddingów i nie potrzebuje dostawcy modelu generatywnego do podstawowego zapisu i odczytu. Mode B dodaje model przez Ollama lub zgodny endpoint; przetwarzanie jest lokalne, jeśli endpoint rzeczywiście działa na tym komputerze. Mode C może wysyłać pytania oraz tekst pamięci do wybranego dostawcy.
Przed wyborem przeczytaj porównanie trybów. Początkowe pobieranie modeli, zewnętrzne aplikacje i funkcje online mają osobne wymagania sieciowe. Role, zakresy dostępu, retencja i audyt pomagają kontrolować archiwum, lecz nie są certyfikatem zgodności prawnej.
Weryfikacja odpowiedzi oraz dokumenty
Kontrola odpowiedzi sprawdza, czy zapisane informacje rzeczywiście odpowiadają na pytanie. Laya działa na Apple Silicon i wymaga pobrania około 1,1 GB. Opcjonalny Jev działa online, z własnym kluczem i zgodą użytkownika: zwykle wysyła pytanie oraz trzy wspomnienia; dodatkowe sortowanie może wysłać ich do dwudziestu. Nie daje to gwarancji bezbłędności asystenta.
Opcjonalne indeksowanie multimediów obsługuje zgodne obrazy i strony PDF, OCR oraz odwołania do pliku i strony. Początkowo jest wyłączone, wymaga 16 GB pamięci i dodatkowych modeli. Foldery i bazy Obsidian można odwzorować tylko do odczytu przez slm sources add. Indeksowanie multimediów nie obsługuje Maców Intel ani Windows na ARM.
Integracje, koszty i wymagania
Klienci korzystają ze wspólnego magazynu przez MCP lub integracje. Web access dodaje aplikacje z OAuth oraz prawami odczytu albo odczytu i zapisu. Komputer musi pozostać online; żądania i wyniki przechodzą przez bramę oraz aplikację, mimo lokalnej bazy danych.
Stan na 18 października 2026: lokalny rdzeń jest darmowy na AGPL v3. Dostęp webowy oferuje dzienny limit na połączenie, ale w sprawdzonych stronach nie potwierdzono jednej liczby obowiązującej wszystkich. Dostawcy modeli, Jev i asystenci mogą naliczać osobne opłaty. Gotowe instalacje obejmują Apple Silicon, 64-bitowy Windows i Linux; nie obejmują Maców Intel ani Windows 32-bit.
Częste pytania
Czy pamięć działa offline?
Rdzeń Mode A może pracować lokalnie po przygotowaniu modeli. Dostęp webowy, usługi zewnętrzne i niektórzy asystenci wymagają Internetu.
Czy potrzebny jest klucz API?
Nie do lokalnego rdzenia Mode A. Jev i dostawcy chmurowi wymagają własnych danych dostępowych i mogą rozliczać użycie niezależnie.
Czy pamięć można współdzielić między asystentami?
Tak, przez obsługiwane integracje lub MCP. Wybierz profil i uprawnienia, a następnie przetestuj zapis w jednym kliencie i odczyt w drugim.
Oficjalne materiały
- Repozytorium i dokumentacja: kod, licencja oraz integracje.
- Przykładowe przebiegi pracy: zapis, korekty i odczyt.
- Opis kontroli odpowiedzi: Laya, Jev i przesyłane dane.
Podobne narzędzia
Bazy danych i infrastruktura kontekstu AI →
NitroStackFreemium
Udostępniaj własne API jako narzędzia MCP i sprawdzaj ich działanie przed wdrożeniem.
ParrotZa darmo
Nagrywaj rozmowy, przeglądaj ustalenia i sprawdzaj raport w oryginalnych wypowiedziach.
CopilotKitFreemium
Otwarty SDK łączący rozmowę, funkcje aplikacji i decyzje użytkownika z agentami AI.
guilds.runZa darmo
Uruchamiaj zespoły agentów i sprawdzaj instrukcje, narzędzia oraz pamięć.
BevelCena na zapytanie
Agenci AI w infrastrukturze firmy oraz Hexis do wspólnego zarządzania wiedzą, instrukcjami i narzędziami.