
GleapDe pago
Del mensaje del cliente a la investigación y la corrección revisada.
3AM: AIOps para gestión de incidentes con causas verificadas
Investiga fallos de producción y coordina correcciones con permisos definidos por tu equipo.
En palabras sencillas: ¿para qué sirve 3AM?
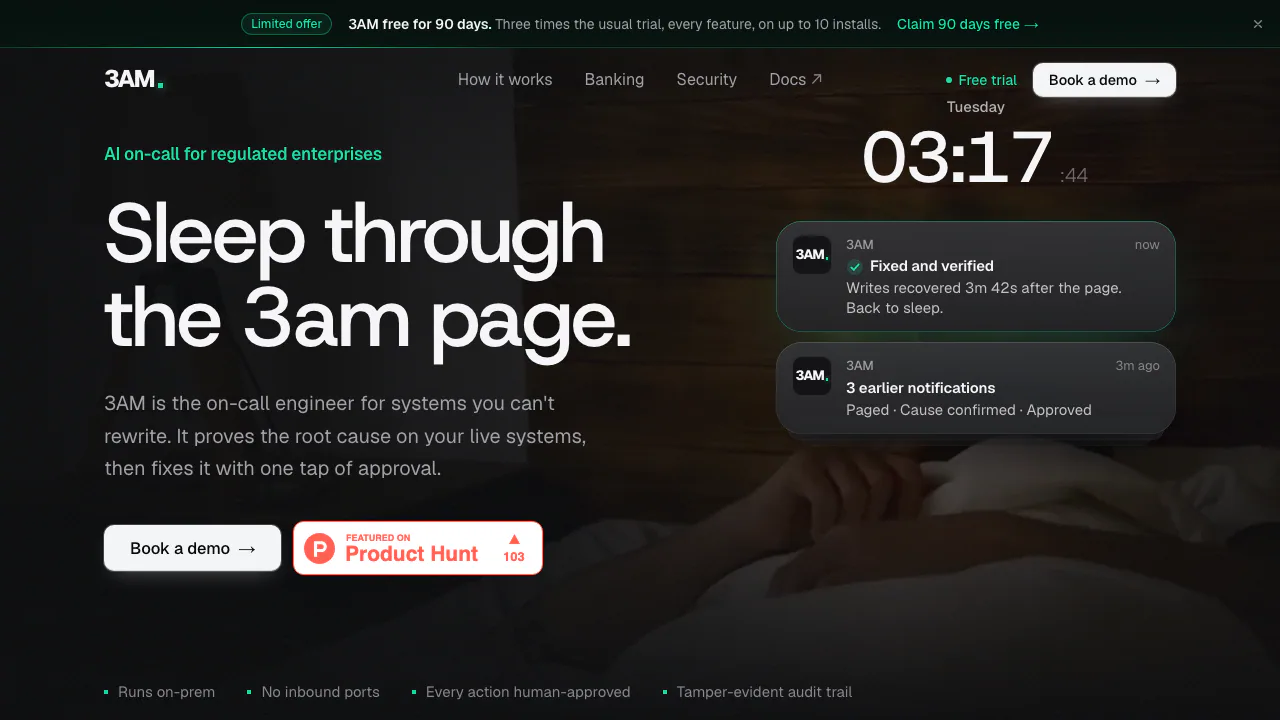
3AM es una herramienta AIOps para la gestión de incidentes que se instala en la infraestructura de la empresa. Recibe señales de monitorización, investiga el origen de una avería y prepara una corrección. El equipo decide si solo observa, pide autorización o ejecuta determinadas acciones permitidas.
Su operador, 3AM Super Intelligence Inc., la orienta a equipos SRE, de plataforma y de operaciones, especialmente en organizaciones reguladas. Ayuda a pasar de «hay una alerta» a una explicación con pruebas y una respuesta controlada.
Investigar la causa raíz con evidencia del sistema
La investigación combina comprobaciones de fallos conocidos, dependencias, despliegues, cambios de configuración, métricas anómalas y errores. Los manuales y los modelos aportan pistas, pero una causa debe superar comprobaciones en los sistemas reales para considerarse probada. Las conclusiones inciertas o contradictorias se derivan a una persona.
Por ejemplo, ante errores de escritura puede comprobar si la base de datos primaria ha quedado en modo de solo lectura. El resultado útil incluye la configuración observada, su relación con el síntoma y las pruebas realizadas. No garantiza resolver cualquier incidencia ni hacerlo en un plazo universal.
Prometheus/Alertmanager, PagerDuty, Kubernetes, MySQL/PostgreSQL, Argo CD y las acciones SSH controladas figuran entre los conectores certificados. Slack, Grafana y Datadog están disponibles con certificación todavía en curso. Conviene comprobar qué señales, permisos y acciones ofrece cada conexión. También dispone de una API HTTP JSON autenticada para integraciones.
Elegir quién autoriza cada cambio
- Shadow: investiga, ensaya y registra propuestas sin modificar sistemas.
- L1: verifica la causa, ensaya la reparación, solicita aprobación, ejecuta y comprueba el resultado.
- L2: permite además ciertas acciones consideradas seguras sin aprobación individual, como un escalado acotado o el reinicio progresivo de un Deployment sin estado.
Elevar la autonomía de un servicio requiere por defecto dos aprobadores distintos. Reducirla se aplica de inmediato. El control de parada bloquea acciones mientras el diagnóstico puede continuar. El alcance debe definirse por servicio y con permisos adecuados.
Datos locales y modelos externos: una distinción importante
Los registros de incidentes y el historial de auditoría firmado y enlazado mediante hashes permanecen en un volumen local. Las credenciales de los conectores pueden guardarse en archivos locales restringidos; se ocultan en el registro de auditoría y en las evidencias enviadas a modelos.
La guía de arquitectura y seguridad explica que un proveedor de modelos externo recibe evidencias depuradas de cada investigación. Para mantener ese procesamiento dentro de la red se necesitan modelos locales o un endpoint interno. La licencia admite verificación sin conexión; en modo conectado se intercambian metadatos de licencia y uso, no los registros del incidente. Las condiciones de conservación del proveedor externo se revisan por separado.
Probar el flujo sin cambiar producción
El servidor debe usar Linux x86_64 o Kubernetes. La prueba admite desde 2 vCPU, 4 GB de RAM y 20 GB libres; producción requiere su propio dimensionamiento. Los modelos necesitan GPU o endpoint, como uno interno compatible con OpenAI u OpenRouter. No hay un runtime nativo de servidor para macOS, Windows o ARM.
La guía de inicio rápido propone:
- Instalar en Linux y recibir el código de prueba en el correo corporativo.
- Abrir el túnel SSH indicado y crear el primer propietario con el token inicial.
- Conectar Prometheus y Slack, probando las conexiones antes de guardarlas.
- Ejecutar Discover y conservar Shadow.
- Enviar la alerta de prueba documentada, revisar Incidents y eliminar la regla al terminar.
Si no existe una causa real, la alerta de prueba debe entregarse a una persona. Después se pueden comparar las propuestas registradas con las actuaciones del equipo antes de habilitar L1.
Prueba gratuita y cobertura comercial
Comprobado el 20 de octubre de 2026: la oferta limitada amplía la prueba habitual de 30 a 90 días, con todas las funciones y hasta diez instalaciones, una vez por empresa y con correo corporativo.
La documentación de licencias indica Starter para 50 servicios, Enterprise para 250, ampliables, y hasta diez instalaciones, y Strategic con cobertura ilimitada. Todas las modalidades incluyen usuarios ilimitados. No se publica un precio monetario universal; hay que confirmar importe, soporte y condiciones con el proveedor. Es una licencia comercial para uso interno, no un plan gratuito permanente.
Preguntas frecuentes
¿3AM sustituye a la monitorización?
Trabaja sobre sus señales para investigar y coordinar una respuesta. Sigue necesitando fuentes de monitorización, permisos y personas que atiendan los casos no resueltos.
¿Puede modificar sistemas sin aprobación?
Shadow no cambia nada y L1 exige aprobación. L2, habilitado por separado, permite acciones seguras concretas sin autorización individual.
¿Es obligatorio tener una GPU?
No, si se utiliza un endpoint de modelos compatible. Su ubicación determina si las evidencias salen de la red.
Recursos oficiales
- Conectores y permisos: acciones y certificación actual.
- Referencia de la API HTTP: autenticación e integración.
- Solicitud de prueba y demostración: iniciar un piloto y consultar condiciones.
Herramientas relacionadas
AIOps y respuesta a incidentes →
readywhenGratis
Recupera compromisos de correos, chats y notas para preparar el seguimiento.
ToriFreemium
Respuestas sobre tu producto y relevo al equipo en la misma conversación.
Inbox ZeroFreemium
Ordena tu buzón, prepara respuestas y reduce las suscripciones que ya no lees.
Craft AgentsGratis
Conecta agentes de IA con archivos, API, MCP y tareas web.
NitroStackFreemium
Convierte tus API en herramientas MCP con TypeScript, pruebas visuales y alojamiento.