
GleapA pagamento
Collega domande, indagini sui bug e modifiche da revisionare.
3AM: AIOps per la gestione degli incidenti con cause verificate
Indaga i guasti di produzione e controlla le correzioni con approvazioni definite dal team.
In parole semplici: a cosa serve 3AM?
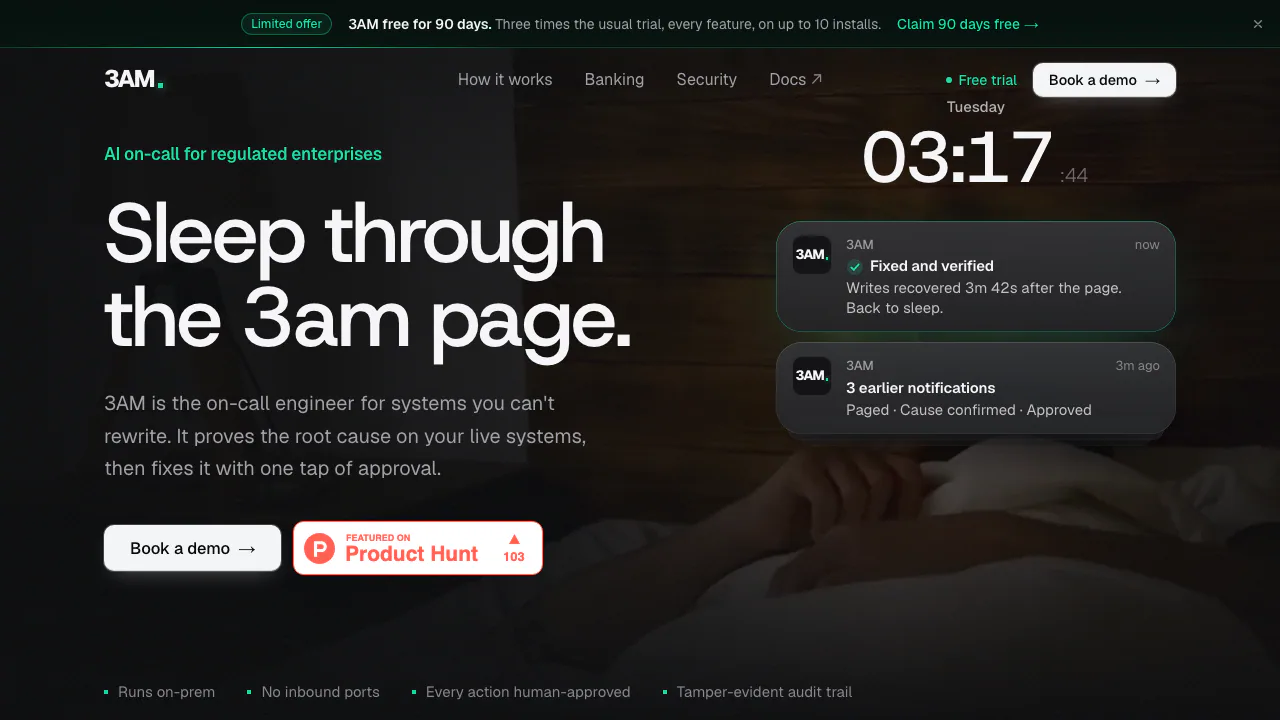
3AM è un prodotto AIOps per la gestione degli incidenti, installato nell'infrastruttura aziendale. Riceve gli allarmi, raccoglie prove, verifica le possibili cause di un guasto e prepara una correzione. Il team stabilisce se debba soltanto osservare, chiedere un'approvazione o svolgere alcune azioni autorizzate.
3AM Super Intelligence Inc. lo propone soprattutto a organizzazioni regolamentate e ai loro team SRE, di piattaforma e di esercizio. Serve a ricostruire perché un servizio non funziona e quali interventi siano giustificati dalle verifiche.
Dalle segnalazioni alla causa verificata
L'indagine esamina controlli sui guasti noti, dipendenze, distribuzioni recenti, modifiche di configurazione, metriche anomale ed errori. Manuali operativi e modelli suggeriscono piste, ma la normale procedura di riparazione richiede prove sui sistemi reali. Se la causa resta incerta o contestata, il caso passa a una persona.
Per esempio, gli errori di scrittura possono portare a controllare se il database primario è diventato di sola lettura. Il risultato utile è il collegamento documentato tra impostazione e sintomo, non una generica raccomandazione di riavvio. Non esiste una garanzia di risoluzione per ogni incidente.
Tra i connettori certificati figurano Prometheus/Alertmanager, PagerDuty, Kubernetes, MySQL/PostgreSQL, Argo CD e azioni SSH controllate. Slack, Grafana e Datadog sono disponibili con certificazione ancora in corso. Verifica sempre capacità e permessi del singolo collegamento. È disponibile anche un'API HTTP JSON autenticata per integrare le funzioni della console.
Stabilire quando può intervenire
Shadow indaga, prova e registra senza modificare i sistemi. L1 verifica la causa, prova la correzione, richiede l'approvazione, esegue e controlla l'esito. L2 consente inoltre azioni definite sicure senza approvazione individuale, come uno scaling limitato o il riavvio progressivo di un Deployment senza stato.
L'aumento dell'autonomia richiede normalmente due approvatori distinti; la riduzione è immediata. Un comando di arresto blocca le azioni lasciando proseguire le indagini. Il perimetro va quindi deciso servizio per servizio.
Modelli, credenziali e traccia di audit
I dati degli incidenti e il registro firmato, concatenato tramite hash, rimangono in un volume locale. Le credenziali dei connettori possono essere conservate in file locali protetti; vengono mascherate nell'audit e nei dati inviati ai modelli.
La guida all'architettura e alla sicurezza chiarisce che un endpoint esterno riceve le prove ripulite dell'indagine. Per elaborare tutto nella rete servono modelli locali o un endpoint interno. La licenza può essere verificata offline; online vengono trasmessi metadati di licenza e utilizzo, non i log degli incidenti. Un fornitore esterno può applicare proprie regole di conservazione.
Prova gratuita e condizioni commerciali
Verifica del 20 ottobre 2026: l'offerta limitata estende la prova abituale da 30 a 90 giorni, con tutte le funzioni e fino a dieci installazioni, una volta per azienda e con email professionale.
La documentazione sulle licenze indica Starter per 50 servizi, Enterprise per 250 servizi ampliabili e fino a dieci installazioni, Strategic con copertura illimitata. Tutti i livelli includono persone illimitate. Non è pubblicato un prezzo monetario universale: importo, durata e supporto vanno concordati. È una licenza commerciale per operazioni interne, non un piano gratuito permanente.
Preparare un pilota in modalità Shadow
L'ambiente richiesto è Linux x86_64 o Kubernetes. Per una prova sono indicati almeno 2 vCPU, 4 GB di RAM e 20 GB liberi; la produzione va dimensionata separatamente. I modelli richiedono GPU oppure endpoint, anche interno compatibile OpenAI o OpenRouter. Non sono disponibili runtime server nativi per macOS, Windows o ARM.
Segui l'avvio rapido ufficiale:
- Installa su Linux e inserisci il codice di prova ricevuto nella casella aziendale.
- Apri il tunnel SSH indicato e crea il primo proprietario usando il token iniziale.
- Collega Prometheus e Slack, provando le connessioni prima di salvarle.
- Esegui Discover e mantieni Shadow.
- Invia l'allarme di test documentato, controlla Incidents e rimuovi la regola al termine.
Un test senza causa reale deve passare a una persona. Confronta poi le proposte con il lavoro effettivo del team prima di richiedere L1.
Domande frequenti
3AM trova sempre la causa del guasto?
No. Una conclusione non dimostrata viene affidata alle persone con le prove disponibili; l'AI può sbagliare o non trovare una risposta.
Che differenza c’è tra Shadow, L1 e L2?
Shadow osserva, L1 interviene dopo approvazione e L2 aggiunge specifiche azioni sicure automatiche. L'autonomia si assegna per servizio.
3AM è gratuito?
Esiste una prova aziendale a tempo. L'uso continuativo richiede una licenza valida e condizioni commerciali da confermare.
Risorse ufficiali
- Connettori: permessi, azioni e certificazione.
- Riferimento API HTTP: autenticazione ed endpoint.
- Prova e demo: avviare un pilota e chiedere un'offerta.
Strumenti correlati
AIOps e risposta agli incidenti →
readywhenGratis
Dalle promesse nelle conversazioni alle bozze da controllare e approvare.
ToriFreemium
Risposte sul prodotto dalle tue fonti, con il team pronto a intervenire.
Inbox ZeroFreemium
Ordina la posta, prepara risposte e ripulisci le newsletter che non leggi.
Craft AgentsGratis
Collega gli agenti AI a file, API, MCP e attività nel browser.
NitroStackFreemium
Trasforma API e funzioni aziendali in strumenti MCP con TypeScript e test visuali.